
같은 회로도 공정, 전압, 온도에 따라 속도가 몇 배씩 달라진다. PVT corner의 이름과 쓰임을 SkyWater 130 nm library의 실제 수치로 확인하고, signoff에서 corner를 어떻게 고르는지 정리한다.
PVT는 transistor의 속도를 흔드는 공정, 전압, 온도다
칩 하나의 timing은 정해진 한 값이 아니다. 같은 netlist라도 어느 wafer에서 나왔는지, 전원이 얼마나 출렁이는지, 칩이 얼마나 뜨거운지에 따라 transistor가 흘리는 전류가 달라지고, 그만큼 gate delay가 달라진다. 이 세 가지를 process, voltage, temperature의 머리글자를 따서 PVT라고 부르고, 각 값을 극단까지 밀어 놓은 조합 하나하나를 corner라고 부른다. 설계가 모든 corner에서 동작하면 그 사이의 어떤 조건에서도 동작할 가능성이 높다는 것이 corner 방식의 전제다(Harris).
process는 만들 때 생기는 차이다. 같은 mask로 찍어도 lot과 wafer, die마다 doping 농도 같은 값이 조금씩 달라서 transistor가 평균보다 빠르게도, 느리게도 나온다. foundry는 이 분포의 끝, 보통 평균에서 3σ나 6σ 떨어진 지점을 따로 model로 만들어 준다(Wikipedia). corner가 다루는 것은 die 전체가 함께 빨라지거나 느려지는 차이이고, 한 die 안에서 위치마다 다른 차이는 뒤에서 볼 OCV가 따로 다룬다.
voltage는 칩 안의 transistor에 실제로 걸리는 전원 전압이다. 이 값은 regulator가 맞춘 공칭값보다 낮아지곤 하는데, 이렇게 전원 전압이 처지는 것을 droop이라고 한다. 원인은 둘이다. 하나는 칩이 끌어가는 전류가 전원망의 저항을 지나며 생기는 IR drop이고, 다른 하나는 전류가 갑자기 늘 때 package와 board의 inductance가 만드는 L·di/dt noise다. Harris의 예제에서 1.2 V로 24 W를 쓰는 칩은 전원 쪽 임피던스 5 mΩ만으로 100 mV가 떨어지고, 10 ns 사이에 5 W에서 53 W로 바뀌는 칩은 bypass capacitor가 없다면 0.1 nH의 inductance만으로 0.4 V가 처진다(Harris). 그래서 전원망과 bypass capacitor는 droop을 공칭 전압의 ±10% 안에 묶도록 설계하고, timing도 regulator의 오차와 droop을 합친 ±10% 범위에서 확인한다(Harris).
전압이 낮으면 transistor의 전류가 줄어 느려지고, 높으면 빨라지는 대신 전력과 leakage가 커진다. 전압과 delay의 관계는 SRAM 글의 동작 전압 절에서 식으로 다뤘다.
temperature는 주변 온도에 칩이 스스로 내는 열이 더해진 die의 온도다(Harris). 온도가 오르면 carrier mobility가 떨어져 전류가 줄고, 동시에 threshold voltage(Vth)도 내려가 전류를 늘리는 쪽으로 작용한다. Harris의 강의 자료는 둘을 합쳐 온도가 오르면 on 전류는 줄고 off 전류, 곧 leakage는 는다고 정리한다(Harris). 그래서 오랫동안 뜨거울수록 느리다고 보았는데, 이 규칙이 뒤집히는 경우를 뒤에서 실제 수치로 본다.
TT, SS, FF의 두 글자는 nMOS와 pMOS의 속도다
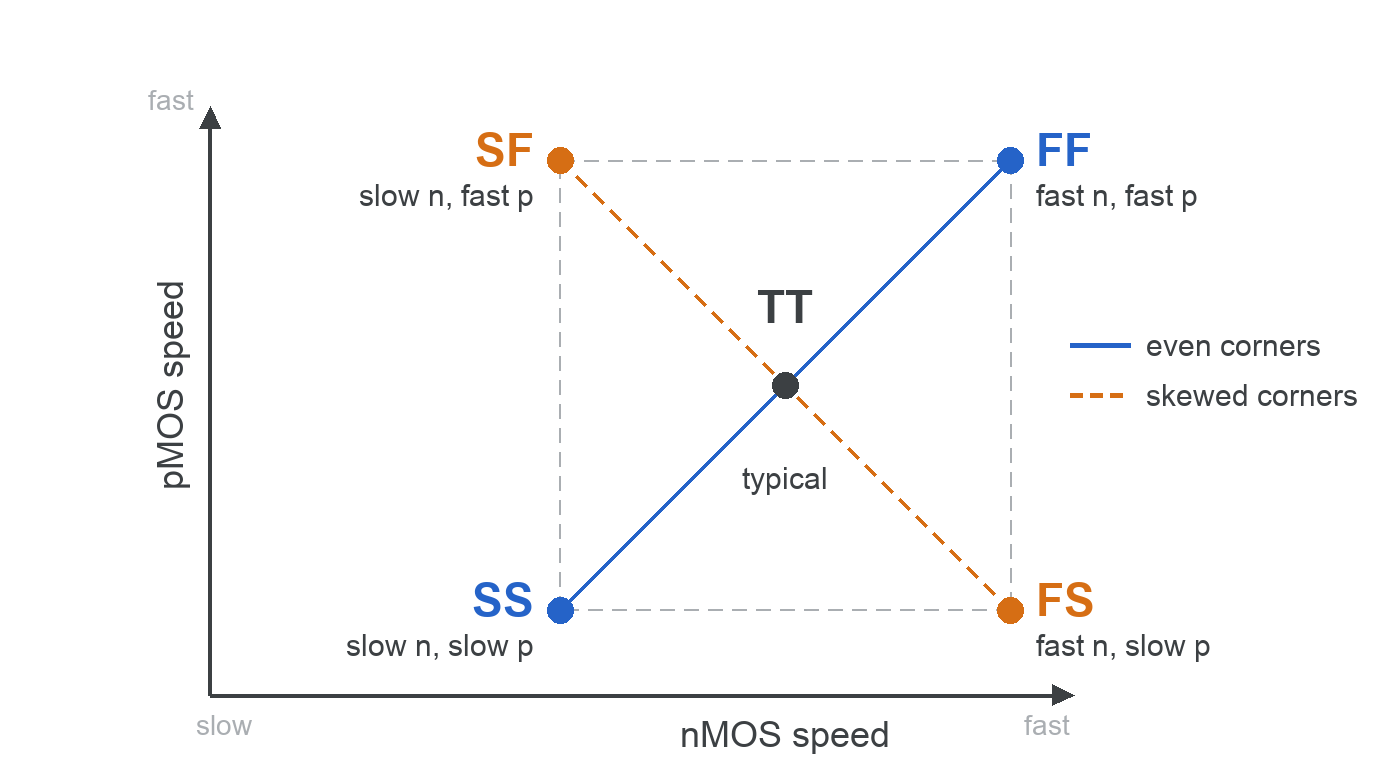
process corner의 이름은 두 글자이고, 앞 글자가 nMOS, 뒤 글자가 pMOS의 속도다. T는 typical, F는 fast, S는 slow여서 조합은 TT, FF, SS, FS, SF 다섯이다(Wikipedia). 그림에서 가로축이 nMOS, 세로축이 pMOS의 속도이고, TT는 엄밀히 말하면 꼭짓점이 아니라 가운데 점이지만 관례상 corner라고 부른다.
여기서 빠르고 느린 것은 전압이나 온도가 아니라 만들어진 transistor 자체의 성질이다. Harris는 fast transistor를 effective channel length(Leff)가 짧고, Vth가 낮고, gate oxide 두께(tox)가 얇은 것으로, slow transistor를 그 반대로 정리한다. 셋 다 같은 전압과 온도에서 transistor가 더 많은 전류를 흘리게 하는 방향이다. nMOS와 pMOS는 따로 정해지는 parameter가 있어서 한쪽만 빠를 수 있지만, 모든 parameter가 서로 독립인 것은 아니다(Harris).
SS와 FF처럼 두 transistor가 같은 방향으로 움직이는 corner를 even corner라고 한다. 이때 회로는 전체가 느려지거나 빨라질 뿐 논리가 틀리지는 않아서, 느린 칩은 낮은 주파수로 파는 binning으로 흡수할 수 있다. FS와 SF는 한쪽만 빠른 skewed corner다. nMOS가 끌어내리는 falling edge와 pMOS가 끌어올리는 rising edge의 속도가 크게 달라지므로, 두 transistor가 서로 힘을 겨루는 회로에서 문제가 된다(Birla 외).
배선, 전압, 온도에도 S와 F를 붙인다
transistor 두 글자 뒤에 배선, 전압, 온도의 글자를 붙여 corner를 더 자세히 적기도 한다. Harris는 nMOS, pMOS, 전압, 온도의 네 글자로 적다가, corner마다 확인할 것을 정리할 때는 배선을 더한 다섯 글자로 적는다(Harris 4강, 16강). 각 칸의 S, T, F가 무엇인지 모으면 아래와 같다. 전압과 온도의 값은 Harris가 1.8 V 공정의 예로 든 숫자다.
| 칸 | S (느린 쪽) | T | F (빠른 쪽) | 무엇이 다른가 |
|---|---|---|---|---|
| nMOS | 전류가 적게 흐르는 nMOS | 평균 | 전류가 많이 흐르는 nMOS | Leff, Vth, tox (만들 때 정해짐) |
| pMOS | 전류가 적게 흐르는 pMOS | 평균 | 전류가 많이 흐르는 pMOS | nMOS와 같음 |
| 배선 | R과 C가 커서 신호가 늦게 지나가는 배선 | 평균 | R과 C가 작은 배선 | 금속의 폭, 두께, 간격 |
| 전압 | 낮은 VDD (1.62 V) | 1.8 V | 높은 VDD (1.98 V) | regulator 오차와 droop |
| 온도 | 높은 온도 (125°C) | 70°C | 낮은 온도 (0°C) | 주변 온도와 칩의 발열 |
글자는 값의 크고 작음이 아니라 회로를 느리게 하는 쪽이냐 빠르게 하는 쪽이냐로 붙인다(Harris). 그래서 전압은 낮은 쪽이 S이고 온도는 높은 쪽이 S다. 온도의 S가 높은 온도인 것은 뜨거울수록 느리다는 전제를 깐 것이라, 뒤에서 볼 temperature inversion이 있는 조건에서는 낮은 온도가 오히려 느린 쪽이 된다. 배선의 S와 F는 뒤에서 볼 RC corner를 한 글자로 줄여 적은 것으로 보면 된다.
Harris는 이 다섯 칸을 조합해 corner마다 무엇을 확인하는지 표로 정리했다. 아래는 그 표에서 일부를 옮긴 것이다(Harris).
| nMOS | pMOS | 배선 | 전압 | 온도 | 확인하는 것 |
|---|---|---|---|---|---|
| T | T | T | S | S | binning할 칩의 timing 사양 |
| S | S | S | S | S | 보수적인 timing 사양 |
| F | F | F | F | F | race, hold time, pulse가 사라지는 문제, noise |
| F | F | F | F | S | subthreshold leakage와 noise |
| S | S | F | S | S | gate와 배선의 경쟁 (gate가 느리고 배선이 빠름) |
| F | F | S | F | F | gate와 배선의 경쟁 (gate가 빠르고 배선이 느림) |
| S | F | T | F | F | ratioed circuit의 noise margin, memory read/write (pMOS가 이기기 쉬움) |
| F | S | T | F | F | ratioed circuit, memory read/write (nMOS가 이기기 쉬움) |
첫 두 줄은 timing 사양을 정하는 corner다. 칩을 하나씩 시험해 등급을 나눠 파는 binning에서는 transistor를 TT로 두고 전압과 온도만 나쁜 쪽에 둔 corner로 사양을 잡고, 모든 칩이 한 사양을 맞춰야 하면 다섯 칸을 모두 S로 둔다. 셋째 줄의 F F F F F는 모든 것이 빨라 data가 너무 일찍 도착하는 hold 쪽 문제를 본다. leakage 줄에서 온도만 S, 곧 높은 온도인 것은 leakage가 뜨거울수록 크기 때문이다. 나머지 네 줄은 두 가지 경쟁을 보는데, 아래에서 차례로 풀어 본다.
gate와 배선은 따로 흔들려서 서로 경쟁한다
경로 하나의 delay는 gate를 지나는 시간과 배선을 지나는 시간의 합이다. 어떤 경로는 gate를 여러 개 지나지만 배선은 짧아서 delay 대부분이 transistor에서 나오고, 어떤 경로는 gate는 몇 개 없이 긴 배선을 지나서 delay 대부분이 배선의 RC에서 나온다. transistor의 속도는 Leff, Vth, tox가 정하고 배선의 RC는 금속의 폭과 두께, 간격이 정하므로 둘은 따로 흔들린다. 그래서 gate가 많은 경로와 배선이 긴 경로가 서로 먼저 도착하려고 겨루면, 둘이 함께 느려지는 corner보다 한쪽만 느려지는 corner에서 순서가 크게 뒤집힌다. Harris가 clock skew의 예로, buffer 크기를 잘 맞추면 두 clock이 이상적으로는 동시에 도착하지만 배선 길이가 다른 가지는 RC 때문에 늘 skew가 남는다고 설명한 것도 같은 이야기다(Harris).
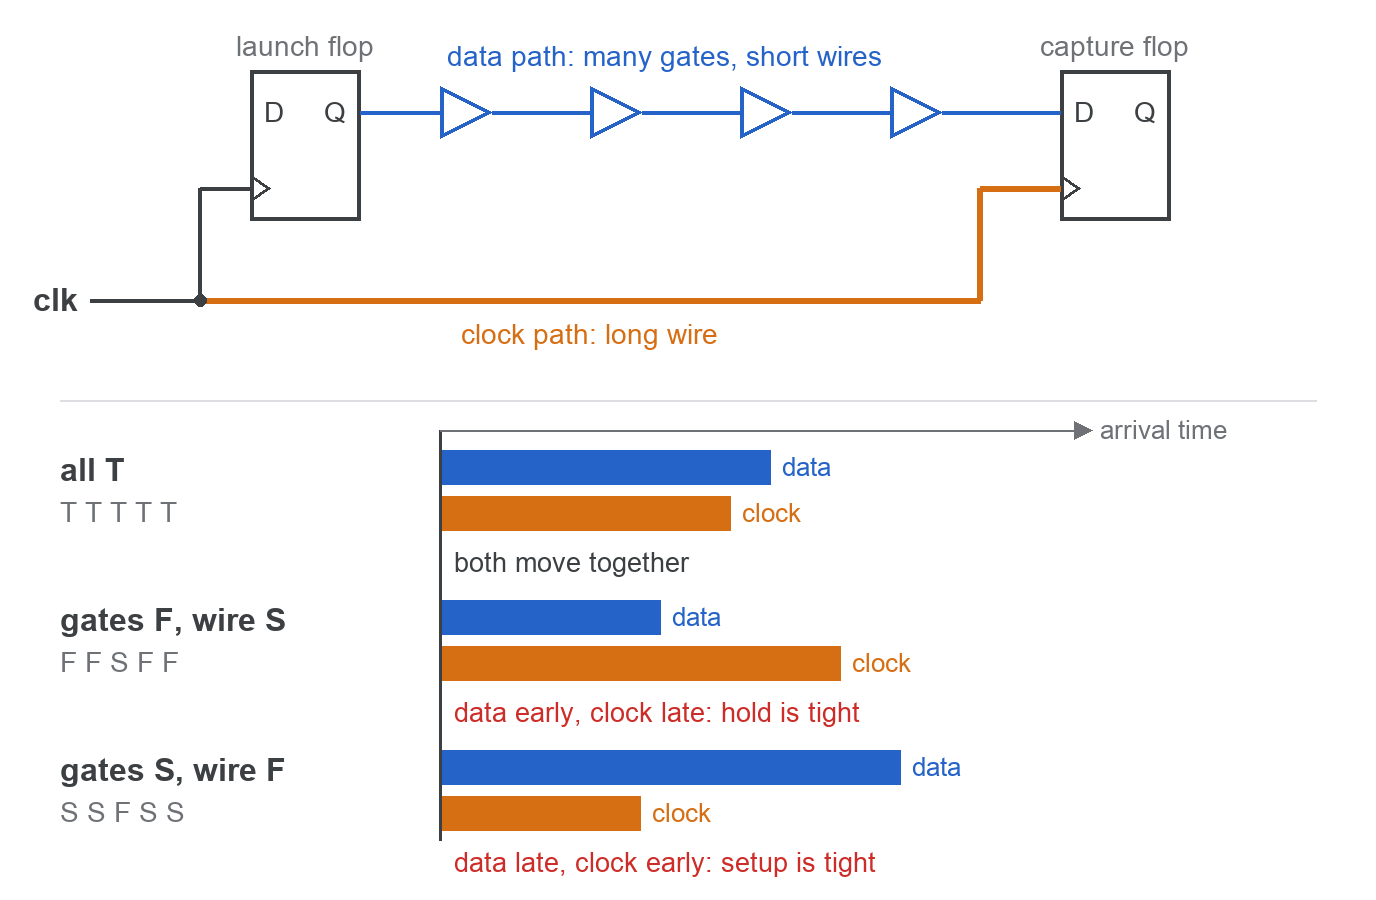
그림 위쪽은 hold check에서 흔히 보는 구도다. data는 launch flip-flop에서 gate 네 개를 지나 짧은 배선으로 capture flip-flop에 닿고, capture flip-flop의 clock은 긴 배선을 지나 도착한다. data 경로는 gate가, clock 경로는 배선이 delay를 정한다. 모든 칸이 T이거나, S S S S S처럼 gate와 배선이 함께 느려지면 두 경로가 같이 늘어나 순서가 크게 바뀌지 않는다. 그런데 gate는 빠르고 배선은 느린 F F S F F에서는 data가 일찍 오고 clock은 늦게 와서 hold가 가장 빠듯해진다. 반대로 gate는 느리고 배선은 빠른 S S F S S에서는 data가 늦고 clock이 일찍 와서 setup이 빠듯해진다. Harris의 표에 이 두 corner가 따로 있는 이유다. 막대의 길이는 순서를 보이기 위한 것이고 실제 값은 아니다.
SF에서는 pMOS가, FS에서는 nMOS가 이기기 쉽다
skewed corner가 왜 따로 필요한지는 pMOS와 nMOS가 같은 node에 동시에 켜지는 경우를 떠올려야 보인다. inverter나 NAND 같은 보통의 CMOS gate는 pMOS 쪽(pull-up)과 nMOS 쪽(pull-down) 가운데 한쪽만 켜지도록 만든다. 그래서 output은 VDD나 0 V까지 끝까지 가고, Harris의 표현대로 이런 gate는 언제나 0이나 1을 낸다(Harris). 이런 gate에서 skewed corner가 바꾸는 것은 rise와 fall의 속도뿐이고, 값이 틀리지는 않는다.
그런데 어떤 회로는 pMOS와 nMOS가 같은 node에 함께 켜져 있는 순간이 있다. Harris는 이 상태를 crowbar라고 부르는데(Harris), 이때 node의 전압은 0 V도 VDD도 아닌 중간값이 된다. 두 transistor가 각자 node를 반대쪽으로 끌어당기므로, 저항 두 개로 전압을 나눌 때처럼 둘의 세기 비율로 전압이 정해진다. pMOS가 세면 node가 VDD 쪽에, nMOS가 세면 0 V 쪽에 자리 잡는다. 이렇게 세기의 비율에 기대는 회로를 ratioed circuit이라고 한다. 이 회로가 0과 1을 제대로 내는지는 그 중간값이 다음 gate가 뒤집히는 전압, 곧 switching point(VM)보다 아래냐 위냐로 정해진다.
그래서 ratioed circuit은 두 종류로 나뉜다. node를 0으로 만들어야 하는 회로에서는 nMOS가 pMOS보다 충분히 세서 node를 VM 아래로 끌어내려야 한다. 이것이 nMOS가 pMOS를 이겨야 동작하는 회로다. 반대로 node를 1로 지켜야 하는 회로에서는 nMOS가 끌어내리는 힘을 pMOS가 버텨 node를 VM 위에 붙잡아 두어야 한다. 이것이 pMOS가 nMOS를 버텨야 동작하는 회로다.
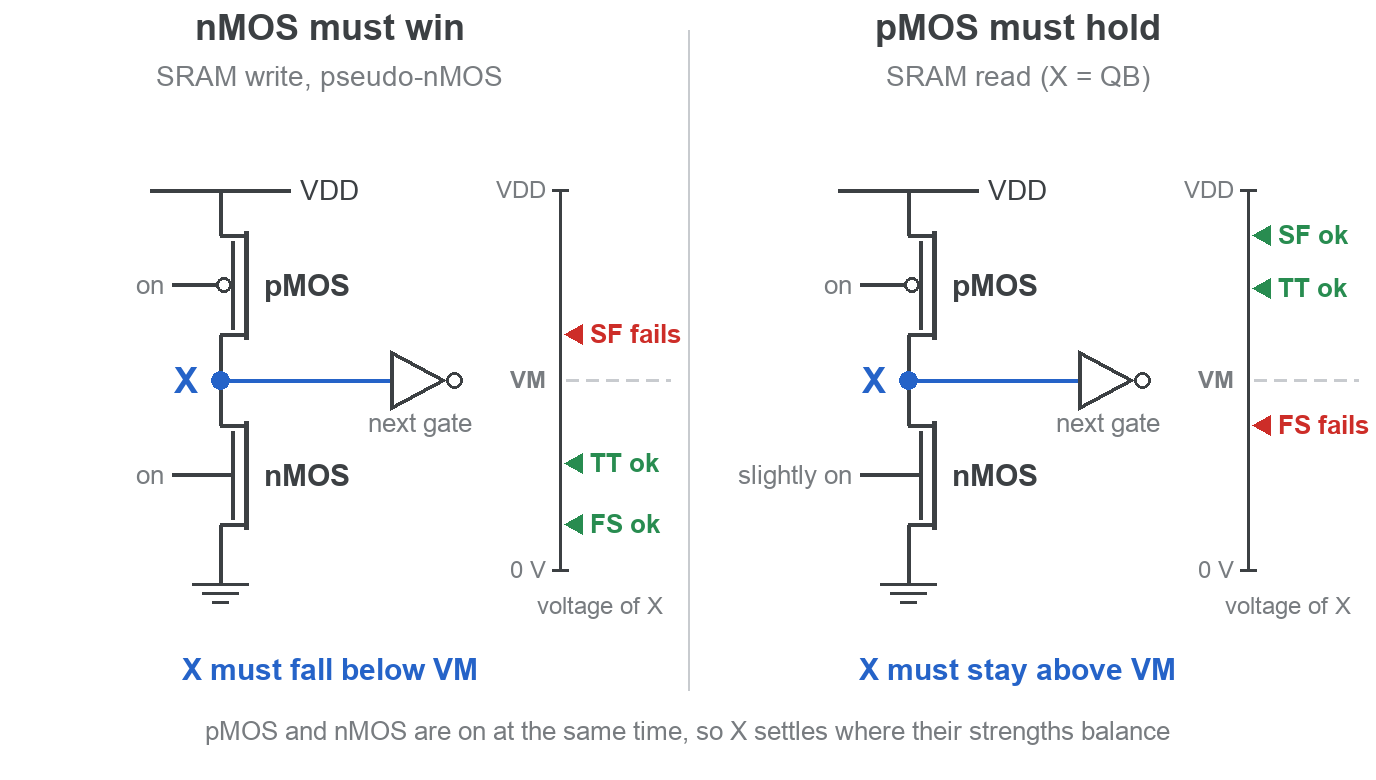
그림의 왼쪽은 node X를 0으로 만들어야 하는 경우다. TT와 FS에서는 nMOS가 충분히 세서 X가 VM 아래로 내려가지만, nMOS가 느리고 pMOS가 빠른 SF에서는 X가 VM 위에 걸려 다음 gate가 0을 받지 못한다. 오른쪽은 X를 1로 지켜야 하는 경우인데, 이번에는 nMOS가 빠르고 pMOS가 느린 FS에서 X가 VM 아래로 밀려 다음 gate가 뒤집힌다. 위험한 corner가 서로 반대인 것은 이겨야 하는 쪽이 반대이기 때문이다. 화살표의 높이는 방향을 보이기 위한 것이고 실제 값은 아니다.
| corner | nMOS / pMOS | 이기기 쉬운 쪽 | 위험해지는 회로 |
|---|---|---|---|
| SF | 느림 / 빠름 | pMOS | nMOS가 node를 0으로 끌어내려야 하는 회로 (SRAM write, pseudo-nMOS gate) |
| FS | 빠름 / 느림 | nMOS | pMOS가 node를 1로 지켜야 하는 회로 (SRAM read) |
그림 왼쪽의 대표가 pseudo-nMOS gate다. 이 gate는 pMOS를 늘 켜 두고 nMOS 쪽이 켜질 때 output을 끌어내리는데, nMOS가 이길 수 있도록 pMOS를 pull-down 쪽 세기의 4분의 1쯤으로 작게 만든다(Harris). Harris가 이 gate에서 pMOS가 너무 강해 output이 충분히 내려가지 않는 ratio failure를 ‘SF corner에서만 일어날 수도 있다’고 예로 든 것이 바로 이 경우다(Harris). SRAM 글의 6T bitcell에서 write도 같다. Q가 1인 cell에 0을 쓸 때 Q에는 Q를 1로 붙잡는 pull-up pMOS와, Q를 0 V의 BL로 끌어내리는 access nMOS가 함께 켜져 있다. access nMOS가 이겨 Q를 반대쪽 inverter의 VM 아래로 내려야 cell이 뒤집히므로, nMOS가 느리고 pMOS가 빠른 SF에서 write가 가장 어렵다.
그림 오른쪽의 대표가 SRAM read다. Q가 0인 cell을 읽으면 BL에서 들어오는 전류 때문에 Q가 0에서 조금 떠오른다. Q를 입력으로 받는 inverter에서는 QB를 1로 붙잡는 pMOS가 켜져 있는데, 떠오른 Q 때문에 같은 inverter의 nMOS도 살짝 켜진다. 그림의 X가 바로 이 QB다. pMOS가 버텨 QB를 높게 지키면 cell은 값을 지키지만, nMOS가 강한 FS에서는 QB가 더 많이 끌려 내려가고, QB가 반대쪽 inverter의 VM 아래로 내려가면 Q가 1로 올라가 cell이 뒤집힌다. 같은 이야기를 inverter 하나의 특성으로 보면, switching point는 nMOS와 pMOS의 세기 비율로 정해져 둘이 같지 않으면 VDD/2에서 벗어나고(Harris), FS에서는 이 점이 내려가 Q가 조금만 떠올라도 뒤집힌다. 6T SRAM의 안정성을 정리한 Alorda 외의 글에서 read 때 값을 지키는 여유인 read static noise margin이 FS에서 TT보다 25% 줄고 SF에서 17.1% 느는 것도 이 방향과 맞는다(Alorda 외).
corner마다 Liberty 파일이 하나씩 따로 있다
STA 도구가 cell delay를 계산할 때 읽는 Liberty(.lib) 파일은 cell마다 input slew와 output load에 따른 delay, setup/hold time, 전력을 표로 담고 있다. 이 표는 PVT 한 점에서만 맞는 값이라, OpenLane 문서의 표현대로 .lib 파일 하나는 회로를 corner 하나에서 characterize한 결과다(OpenLane). 그래서 corner 수만큼 .lib가 따로 있다. 아래는 SkyWater 130 nm의 standard cell library인 sky130_fd_sc_hd 저장소에서 corner별 파일 이름을 뽑은 것이다(sky130_fd_sc_hd).
$ ls timing/ | sed "s/sky130_fd_sc_hd__//; s/.lib.json//" | paste - - - | column -t
common                 ff_100C_1v65           ff_100C_1v95
ff_n40C_1v56           ff_n40C_1v65           ff_n40C_1v76
ff_n40C_1v95_ccsnoise  ss_100C_1v40           ss_100C_1v60
ss_n40C_1v28           ss_n40C_1v35           ss_n40C_1v40
ss_n40C_1v44           ss_n40C_1v60_ccsnoise  ss_n40C_1v76
tt_025C_1v80           tt_100C_1v80
이름은 process, 온도, 전압 순서다. ff_n40C_1v95는 FF process, −40°C, 1.95 V이고, ss_100C_1v60은 SS, 100°C, 1.60 V다. 공칭 전압이 1.8 V이므로 1.60 V와 1.95 V는 대략 −11%와 +8%에 해당한다. common은 단위와 표 형식 같은 공통 정의이고, ccsnoise가 붙은 두 파일은 noise 해석용 정보가 더 들어 있는 판이다. 눈여겨볼 점은 process 이름이 tt, ss, ff 셋뿐이라는 것이다.
transistor model 쪽에는 skewed corner도 있다. 같은 PDK의 SPICE model library인 sky130.lib.spice는 tt, sf, ff, ss, fs 다섯 corner와 저항, capacitor용 corner, 그리고 transistor 사이의 mismatch parameter를 함께 준다(sky130_fd_pr). skewed corner는 SRAM bitcell이나 analog 회로처럼 transistor 수준에서 simulation하는 회로를 위한 것이고, 적어도 sky130_fd_sc_hd의 timing library는 even corner로만 나온다.
macro도 마찬가지로 corner마다 .lib가 있어야 한다. SRAM 글에서 쓴 OpenRAM의 sky130 SRAM macro는 datasheet에 characterization corner가 TT, 1.8 V, 25°C 하나만 적혀 있다(sky130_sram_macros). 그대로는 SS나 FF corner에서 SRAM의 timing을 볼 수 없으므로, 실제 칩에 쓰려면 다른 corner의 .lib를 따로 만들어야 한다.
같은 cell도 corner에 따라 delay가 몇 배씩 달라진다
corner 사이가 얼마나 벌어지는지 sky130_fd_sc_hd의 Liberty 표에서 직접 읽어 보았다. inverter(inv_1)는 input slew 0.1 ns, output load 0.005 pF(inv_1 입력 두 개 정도)에서의 rise와 fall delay를, flip-flop(dfxtp_1)은 같은 조건의 clk-to-Q delay와 setup time을 읽었다. corner마다 표의 눈금이 달라서 같은 조건이 되도록 눈금 사이를 선형으로 보간했고, leakage는 inv_1의 평균 leakage 값이다.
| corner | inv rise (ps) | inv fall (ps) | clk-to-Q (ps) | setup (ps) | inv leakage (nW) |
|---|---|---|---|---|---|
| tt_025C_1v80 | 84 | 59 | 335 | 122 | 0.0053 |
| ss_100C_1v60 | 110 | 95 | 663 | 273 | 4.0 |
| ss_n40C_1v60 | 138 | 87 | 724 | 366 | 0.00027 |
| ff_n40C_1v95 | 69 | 35 | 214 | 88 | 0.0031 |
| ff_100C_1v95 | 57 | 40 | 220 | 70 | 7.6 |
| ss_n40C_1v28 | 285 | 136 | 2278 | 1579 | 0.000017 |
TT에서 335 ps인 clk-to-Q가 SS 1.60 V에서는 663~724 ps로 두 배 안팎이 되고, FF 1.95 V에서는 214~220 ps로 줄어든다. 가장 느린 SS와 가장 빠른 FF 사이는 clk-to-Q로 3.4배이고, setup time은 70 ps에서 366 ps까지 벌어진다. 표 맨 아래는 전압을 1.28 V까지 내린 SS corner인데, clk-to-Q가 2.3 ns까지 늘어난다. 같은 회로라도 어느 corner에 서 있느냐에 따라 한 clock 주기 안에 넣을 수 있는 logic의 양이 몇 배씩 달라지는 셈이다.
전압이 process만큼 크게 작용한다는 것도 보인다. ff_n40C_1v56은 FF process인데도 inverter의 평균 delay가 TT 1.80 V의 1.03배로 거의 같다. leakage는 온도가 지배한다. inv_1의 leakage는 SS 1.60 V에서 −40°C일 때 0.00027 nW, 100°C일 때 4.0 nW로 약 15,000배 차이가 나고, 모든 corner 가운데 가장 큰 값은 FF, 1.95 V, 100°C의 7.6 nW다. Harris의 표에서 leakage를 FF와 높은 전압, 높은 온도에서 보는 이유가 이것이다.
뜨거울수록 느리다는 규칙은 낮은 전압에서 뒤집힌다
온도의 두 효과는 방향이 반대다. Synopsys의 Dasdan과 Hom은 drain 전류를 Id ∝ μ(T)·(VDD − Vth(T))^α로 쓰고, 온도가 오르면 mobility μ와 Vth가 모두 떨어진다고 정리했다(Dasdan, Hom). μ가 떨어지면 전류가 줄고, Vth가 떨어지면 VDD − Vth가 커져 전류가 는다. VDD가 Vth보다 충분히 크면 μ 쪽이 이겨 뜨거울수록 느리지만, VDD가 Vth에 가까워지면 Vth 쪽이 이겨 뜨거울수록 빨라진다. 이것을 inverted temperature dependence(ITD), 현업에서는 흔히 temperature inversion이라고 부른다. Freescale의 엔지니어들은 이 현상이 낮은 전압에서 나타나고 Vth가 높은 cell일수록 더 뚜렷하다고 정리했다(Freescale).
sky130_fd_sc_hd에는 같은 전압에서 온도만 다른 corner 쌍이 있어서 이것을 직접 볼 수 있다. 아래 표는 각 칸에 차가운 쪽과 뜨거운 쪽의 delay를 차례로 적었다(TT는 25°C와 100°C, 나머지는 −40°C와 100°C).
| process, 전압 | inv rise (ps) | inv fall (ps) | clk-to-Q (ps) |
|---|---|---|---|
| SS, 1.40 V | 197 / 137 | 110 / 119 | 1298 / 960 |
| SS, 1.60 V | 138 / 110 | 87 / 95 | 724 / 663 |
| TT, 1.80 V | 84 / 77 | 59 / 62 | 335 / 334 |
| FF, 1.65 V | 86 / 68 | 48 / 51 | 289 / 274 |
| FF, 1.95 V | 69 / 57 | 35 / 40 | 214 / 220 |
모든 전압에서 inverter의 rise delay는 뜨거울 때 짧아지고 fall delay는 길어진다. rise는 pMOS가 output을 끌어올리는 edge이고 fall은 nMOS가 끌어내리는 edge이므로, 이 library에서는 pMOS만 temperature inversion 쪽에 있다는 뜻이다. inv_1의 netlist를 보면 이유가 보인다(sky130_fd_sc_hd).
$ grep fet cells/inv/sky130_fd_sc_hd__inv_1.spice
X0 VGND A Y VNB sky130_fd_pr__nfet_01v8 w=650000u l=150000u
X1 VPWR A Y VPB sky130_fd_pr__pfet_01v8_hvt w=1e+06u l=150000u
nMOS는 일반 nfet_01v8이지만 pMOS는 high-Vt인 pfet_01v8_hvt다. SkyWater 문서의 typical 값으로 W/L = 7/0.15 µm인 transistor의 Vth는 nfet_01v8이 0.645 V, pfet_01v8_hvt가 −0.888 V다(SkyWater PDK). 1.60 V에서 VDD와 Vth의 차이는 nMOS가 약 0.96 V, pMOS가 약 0.71 V여서 pMOS 쪽이 Vth의 변화에 더 크게 흔들린다. flip-flop(dfxtp_1)도 transistor 24개가 이 두 종류 12개씩으로 이루어져 있어 clk-to-Q에는 두 효과가 섞여 나온다. SS 1.40 V에서는 100°C가 26%, SS 1.60 V에서도 100°C가 8% 빠르고, FF 1.95 V에 와서야 −40°C가 3% 빨라진다. 어느 온도가 느린 쪽인지가 전압에 따라 바뀌는 것이다.
이 차이는 corner를 고를 때 바로 드러난다. OpenLane 문서는 온도가 높을수록 transistor가 느리게 switching한다고 설명하고, sky130_fd_sc_hd의 기본 PVT corner로 tt_025C_1v80, ss_100C_1v60, ff_n40C_1v95 세 개를 쓴다(OpenLane). 그런데 위 표에서 같은 SS 1.60 V라도 −40°C 쪽이 clk-to-Q는 61 ps, setup time은 92 ps 더 길다. 뜨거운 SS corner 하나로 setup을 닫으면 차가운 칩에서는 그만큼 margin이 모자랄 수 있다는 뜻이다. Dasdan과 Hom은 ITD가 있으면 전압과 온도를 각각 극단에 두는 식의 corner 정의가 성립하지 않고, hold를 깨는 짧은 경로를 찾기도 어려워진다고 지적했다(Dasdan, Hom). 빠른 쪽도 실제로 단순하지 않아서, FF 1.95 V에서 clk-to-Q와 inverter의 fall은 −40°C가 빠르지만 inverter의 rise는 100°C가 빠르다. UCSC의 multi-corner STA 자료는 오래된 공정에서는 뜨거운 쪽이 가장 느리지만 미세 공정에서는 차가운 쪽이 느린 corner가 될 수 있다며, 원리로 짐작하지 말고 여러 corner를 직접 돌려 보라고 적는다(UCSC VLSI-DA). sky130은 130 nm 공정인데도 high-Vt pMOS 때문에 이미 그런 모습을 보인다.
setup은 느린 corner에서, hold는 빠른 corner에서 깨진다
corner를 여러 개 보는 것은 timing check가 두 방향이기 때문이다. setup은 data가 다음 clock edge보다 setup time만큼 먼저 도착해야 하는 조건이라 경로가 느릴수록 깨지고, hold는 data가 clock edge 뒤 hold time 동안 그대로 있어야 하는 조건이라 경로가 빠를수록 깨진다. 그래서 setup은 느린 corner에서, hold는 빠른 corner에서 확인하는 것이 최소한이다(UCSC VLSI-DA). 두 check의 정의와 파형은 setup/hold 글에서 다뤘다.
두 check의 무게는 다르다. setup이 깨진 칩은 clock 주파수를 낮추면 동작하므로, Harris의 표처럼 사양을 정하고 느린 칩은 낮은 등급으로 파는 binning이 가능하다. hold는 같은 clock edge에서 launch와 capture가 함께 일어나는 경쟁이라 주파수를 바꿔도 고쳐지지 않는다. Teman의 강의는 여기에 crosstalk(SI)까지 hold에 영향을 주므로 hold는 모든 corner에서 확인하라고 정리한다(Teman).
배선에도 corner가 있다
corner를 이루는 것은 transistor만이 아니다. 금속 배선도 만들 때 폭과 두께, 층 사이 간격이 흔들려 저항(R)과 capacitance(C)가 달라진다. 그래서 layout에서 parasitic을 뽑는 extraction도 여러 조건으로 돌리는데, 흔히 쓰는 RC corner는 아래 넷이다(Teman).
| RC corner | R과 C | 주로 쓰는 곳 |
|---|---|---|
| Cworst | C 최대, R 최소 | setup (cell delay는 C를 따른다) |
| Cbest | C 최소, R 최대 | hold |
| RCworst | R 최대, C는 배선 폭에 따라 다름 | 긴 배선이 많은 경로 |
| RCbest | R 최소, C는 배선 폭에 따라 다름 | 긴 배선이 많은 경로 |
sky130의 OpenLane 설정은 이것을 nom, min, max 세 interconnect corner로 단순화했다. corner마다 다른 technology LEF와 OpenRCX extraction rule을 쓰고(OpenLane), 이 셋에 앞의 PVT corner 셋을 곱한 nom_tt_025C_1v80부터 max_ff_n40C_1v95까지 9개를 STA corner로 돈다(openlane2).
mode와 corner를 묶은 analysis view로 한 번에 본다
실제 SoC에는 corner 말고도 mode가 여럿이다. 정상 동작, 저전력 동작, scan test처럼 clock 주파수와 전압이 다른 동작마다 SDC가 따로 있고, 전원 domain이 여럿이면 domain마다 전압도 다르다. 여기에 transistor corner, 전압, 온도, RC corner를 곱하면 setup과 hold를 볼 조합이 쉽게 수백 개가 된다(Teman). 이것을 한 번의 STA로 다루는 방식이 multi-mode multi-corner(MMMC, MCMM이라고도 한다)다.
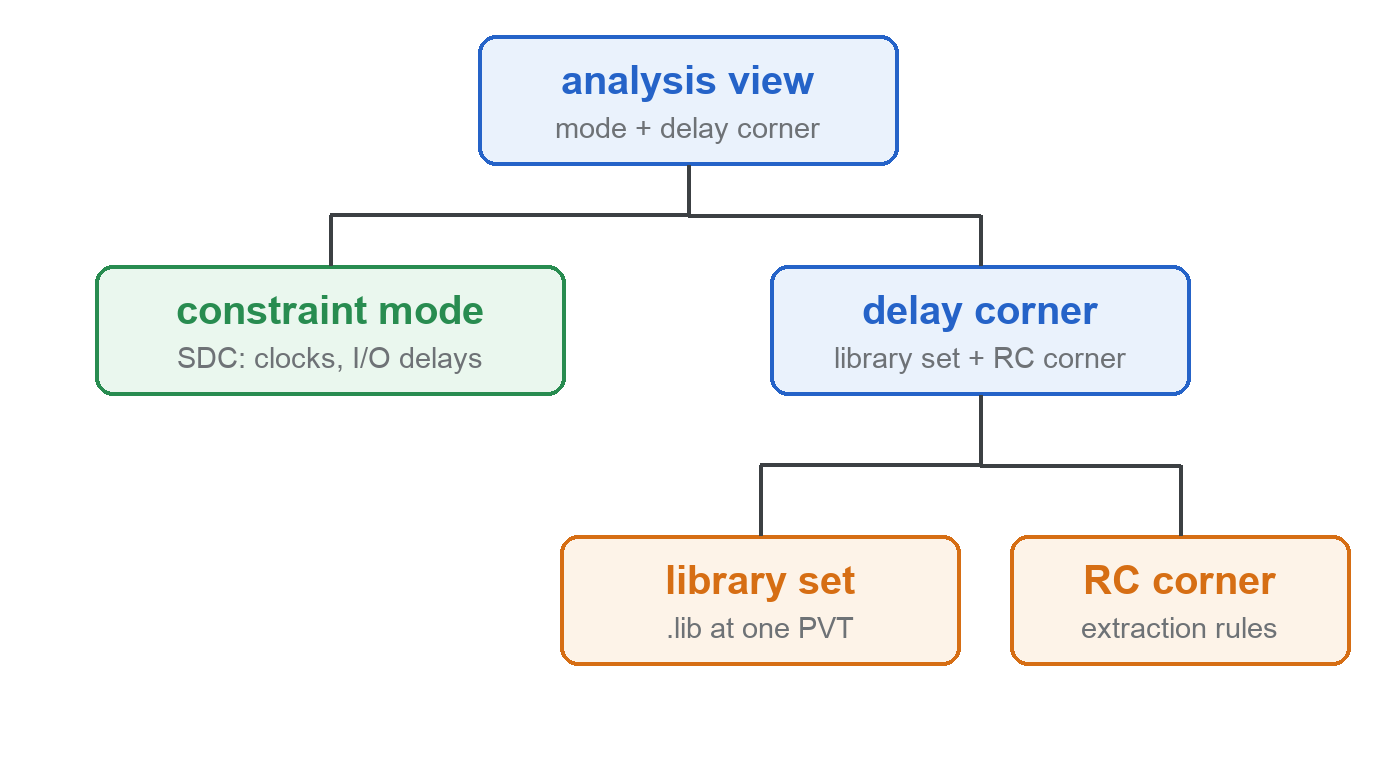
MMMC의 단위는 analysis view다. view 하나는 어떤 SDC로 볼지 정하는 constraint mode와, delay를 어떻게 계산할지 정하는 delay corner의 짝이다. delay corner는 다시 PVT 한 점에서 characterize한 .lib의 묶음인 library set과, extraction 조건인 RC corner로 이루어진다. library set에는 standard cell뿐 아니라 SRAM과 I/O의 .lib도 같은 PVT의 것으로 들어간다. Teman의 강의 예시는 2 GHz의 turbo mode를 SS, 1.2 V, 125°C에서, 50 MHz의 저전력 mode를 SS, 0.5 V, 125°C에서 보는 두 view로 setup을 확인하고, turbo mode를 FF, 1.3 V, −40°C로 보는 view로 hold를 확인한다(Teman). 다만 0.5 V처럼 낮은 전압에서는 앞에서 본 temperature inversion 때문에 125°C가 가장 느린 온도라고 장담할 수 없고, 같은 강의도 그 점을 corner가 늘어나는 이유로 꼽는다.
오픈소스 STA인 OpenSTA에서도 같은 구조를 쓴다. corner 이름을 정하고 corner마다 .lib와 SPEF를 읽은 뒤, setup은 느린 corner의 max path로, hold는 빠른 corner의 min path로 확인한다. 아래는 UCSC의 sky130 예제를 옮긴 것이고, .lib를 읽는 명령은 OpenSTA의 read_liberty로 적었다(UCSC VLSI-DA). 최근 OpenSTA는 define_corners를 mode, .lib, SPEF를 한데 묶는 define_scene으로 바꾸고 있는데(OpenSTA), 묶는 단위가 앞의 analysis view와 같다.
define_corners wc bc typ
read_liberty -corner wc  sky130_fd_sc_hd__ss_100C_1v60.lib
read_liberty -corner bc  sky130_fd_sc_hd__ff_n40C_1v95.lib
read_liberty -corner typ sky130_fd_sc_hd__tt_025C_1v80.lib
read_db odb/spm.odb
read_spef -corner wc  spef/max/spm.max.spef
read_spef -corner bc  spef/min/spm.min.spef
read_spef -corner typ spef/nom/spm.nom.spef
read_sdc sdc/spm.sdc
# setup on the slow corner, hold on the fast corner
report_checks -corner wc -path_delay max
report_checks -corner bc -path_delay min
corner 안의 흔들림은 OCV와 margin으로 덮는다
corner는 die 전체가 함께 움직이는 차이를 다룬다. 그런데 한 die 안에서도 위치마다 transistor와 전압, 온도가 조금씩 다르고, launch 쪽 경로와 capture 쪽 경로가 반대 방향으로 흔들릴 수 있다. setup이라면 data 경로가 더 느리고 capture clock 경로가 더 빠른 경우가, hold라면 그 반대가 최악이다. on-chip variation(OCV)은 이것을 같은 corner 안에서 경로마다 delay에 계수(derate)를 곱해 덮는다. 강의의 예시는 setup을 볼 때 launch clock과 data 경로에 1.2를, capture clock 경로에 0.9를 곱하는 식이다(Teman).
모든 경로에 같은 계수를 곱하면 지나치게 비관적이다. 그래서 launch와 capture가 함께 지나는 clock 구간에서는 derate를 빼 주고(CRPR), 경로의 깊이와 거리에 따라 계수를 다르게 주는 AOCV, cell마다 delay의 분포를 library에 담아 경로의 분포를 계산하는 POCV(SOCV라고도 한다)로 발전해 왔다. POCV에 쓰는 cell별 분포는 Liberty의 LVF(Liberty Variation Format)로 담는다(Teman). Harris도 variation이 커질수록 최악 corner만으로는 실용적인 설계가 어려울 만큼 비관적이 되어 Monte Carlo simulation을 쓴다고 설명한다(Harris).
margin은 공짜가 아니다. 비관적으로 잡을수록 칩이 동작할 가능성은 높아지지만, timing을 맞추느라 cell이 커지고 전력이 늘고 일정이 길어진다. 여기에 쓰면서 transistor의 Vth가 바뀌는 aging(NBTI, HCI 등)까지 margin을 더하거나 aging을 반영한 library로 확인한다(Teman, Harris).
정리하면 PVT corner는 TT, SS, FF 세 글자로 끝나는 이야기가 아니다. 어떤 corner가 가장 느린지는 공정과 전압, cell의 Vth에 따라 달라지고, sky130에서처럼 차가운 쪽이 느린 경우도 있다. 그래서 새 library를 받으면 기본 corner 목록을 그대로 믿기보다, 이 글에서 한 것처럼 .lib의 delay 표를 corner별로 한 번 뽑아 어느 쪽이 느리고 빠른지 확인해 두는 편이 안전하다.
참고 자료
- Harris, CMOS VLSI Design Lecture 4: Nonideal Transistor Theory
- Harris, CMOS VLSI Design Lecture 1: Circuits & Layout (complementary CMOS)
- Harris, CMOS VLSI Design Lecture 5: DC and Transient Response (beta ratio)
- Harris, CMOS VLSI Design Lecture 10: Circuit Families (pseudo-nMOS)
- Harris, CMOS VLSI Design Lecture 16: Circuit Pitfalls (corner checks)
- Harris, CMOS VLSI Design Lecture 21: Package, Power, and Clock (droop)
- Wikipedia, Process corners
- Birla et al., Analysis of 8T SRAM Cell at Various Process Corners at 65 nm (Circuits and Systems, 2011)
- Alorda, Torrens, Bota, 6T CMOS SRAM Stability in Nanoelectronic Era (IntechOpen, 2018)
- Dasdan, Hom, Handling Inverted Temperature Dependence in Static Timing Analysis (ACM TODAES, 2006)
- Mahajan et al. (Freescale), Intelligent Vt structuring to avoid Temperature Inversion
- SkyWater, sky130_fd_sc_hd timing (corner별 Liberty)