
SRAM macro가 bit 하나를 읽고 쓰는 원리부터, 메모리 컴파일러로 macro를 만들 때 고르는 word와 bit, column mux, bank, bitcell, 동작 전압이 면적과 속도, 전력을 어떻게 바꾸는지까지 정리한다.
SRAM은 Static Random-Access Memory이고, 한 덩어리로 놓는 hard macro다
SRAM은 Static Random-Access Memory의 약자다. random access는 address만 주면 어느 위치든 순서와 상관없이 바로 읽고 쓸 수 있다는 뜻으로, shift register나 FIFO처럼 정해진 순서로만 꺼내는 serial access memory와 구별하는 말이다(Harris). static은 DRAM과 구별하는 말이다. DRAM은 capacitor에 전하로 값을 담는데 전하가 새어 나가므로 주기적으로 다시 써 주는 refresh가 필요하다. SRAM은 뒤에서 볼 inverter 두 개가 서로를 붙잡고 있어서 전원만 있으면 refresh 없이 값을 유지한다(Wikipedia). 그 대신 bit 하나에 transistor가 6개 들어가 DRAM보다 크다.
현업에서 SRAM을 SRAM macro라고 부르는 것은 physical design에서 SRAM을 다루는 방식 때문이다. macro라는 말은 gate array 시절부터 썼다. Smith의 ASIC 교과서(Application-Specific Integrated Circuits, 1997)는 gate array library의 logic cell을 흔히 macro라고 부른다고 설명한다. 모든 cell이 같은 base cell layout 위에 있고 cell 안팎의 배선만 바꿔 기능을 만드는 것이, 이름 하나가 정해진 명령 묶음으로 펼쳐지는 software의 macro와 닮았기 때문이다. 지금은 RTL로 주는 IP를 soft macro, layout까지 끝나 mask에 그대로 올릴 수 있는 IP를 hard macro라고 부른다(Wikipedia). 메모리 컴파일러가 만든 SRAM은 layout까지 끝난 hard macro라서, P&R 도구는 이것을 standard cell처럼 흩어 놓지 않고 floorplan에서 자리를 먼저 잡아 한 덩어리로 놓는다.
P&R 도구가 읽는 LEF 파일에도 이 이름이 남아 있다. LEF는 standard cell이든 SRAM이든 모든 cell을 MACRO 문으로 정의하고 CLASS로 구별한다. 아래는 SkyWater 130 nm standard cell library의 inverter와, 오픈소스 메모리 컴파일러 OpenRAM이 만든 1 KB SRAM의 LEF에서 해당 줄을 뽑은 것이다(sky130_fd_sc_hd, sky130_sram_macros).
$ grep -E "^\s*(MACRO|CLASS|SIZE)" *.lef
sky130_fd_sc_hd__inv_1.lef:MACRO sky130_fd_sc_hd__inv_1
sky130_fd_sc_hd__inv_1.lef:  CLASS CORE ;
sky130_fd_sc_hd__inv_1.lef:  SIZE  1.380000 BY  2.720000 ;
sky130_sram_1kbyte_1rw1r_32x256_8.lef:MACRO sky130_sram_1kbyte_1rw1r_32x256_8
sky130_sram_1kbyte_1rw1r_32x256_8.lef:   CLASS BLOCK ;
sky130_sram_1kbyte_1rw1r_32x256_8.lef:   SIZE 479.78 BY 397.5 ;
inverter는 CLASS CORE로 standard cell row에 들어가고, SRAM은 CLASS BLOCK으로 따로 놓인다. 크기는 inverter가 1.38 × 2.72 µm, SRAM이 479.78 × 397.5 µm로 면적이 약 5만 배다.
SRAM macro는 bitcell array와 그 둘레의 회로로 이루어진다
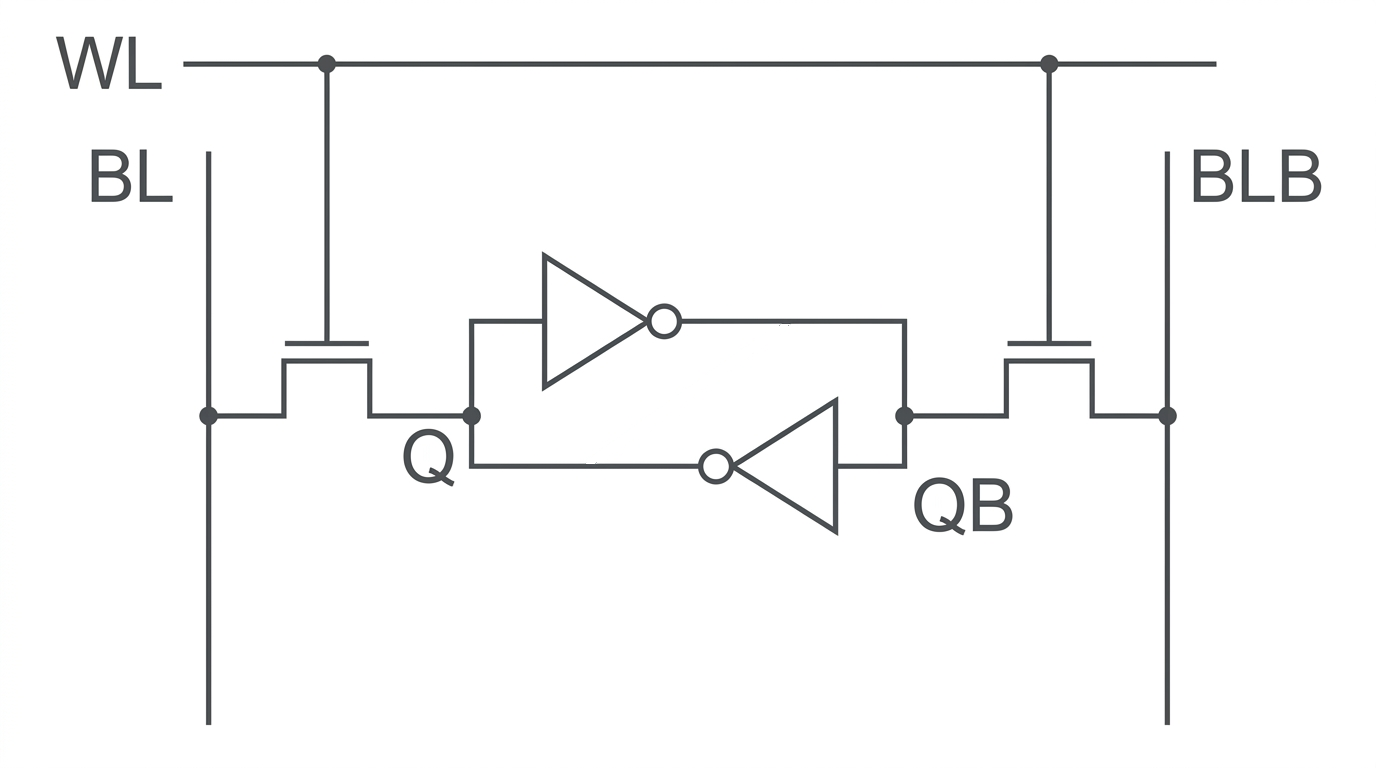
SRAM의 bit 하나를 담는 6T bitcell이다. inverter 두 개가 서로의 출력을 입력으로 받아 Q와 QB에 반대 값을 붙잡고 있다. Q가 0이면 위쪽 inverter가 QB를 1로 만들고, 1인 QB를 받은 아래쪽 inverter가 다시 Q를 0으로 만드는 식이다. 양쪽의 access transistor는 gate가 WL에 연결된 switch다. WL은 row 하나를 고르는 선이라, WL이 0이면 cell은 bitline과 떨어진 채 값을 붙잡고만 있고, WL이 1이 되면 그 row의 cell 전부가 Q는 BL에, QB는 BLB에 연결된다. 연결된 순간 bitline 쪽 회로가 무엇을 하느냐에 따라 read가 되기도 하고 write가 되기도 한다.
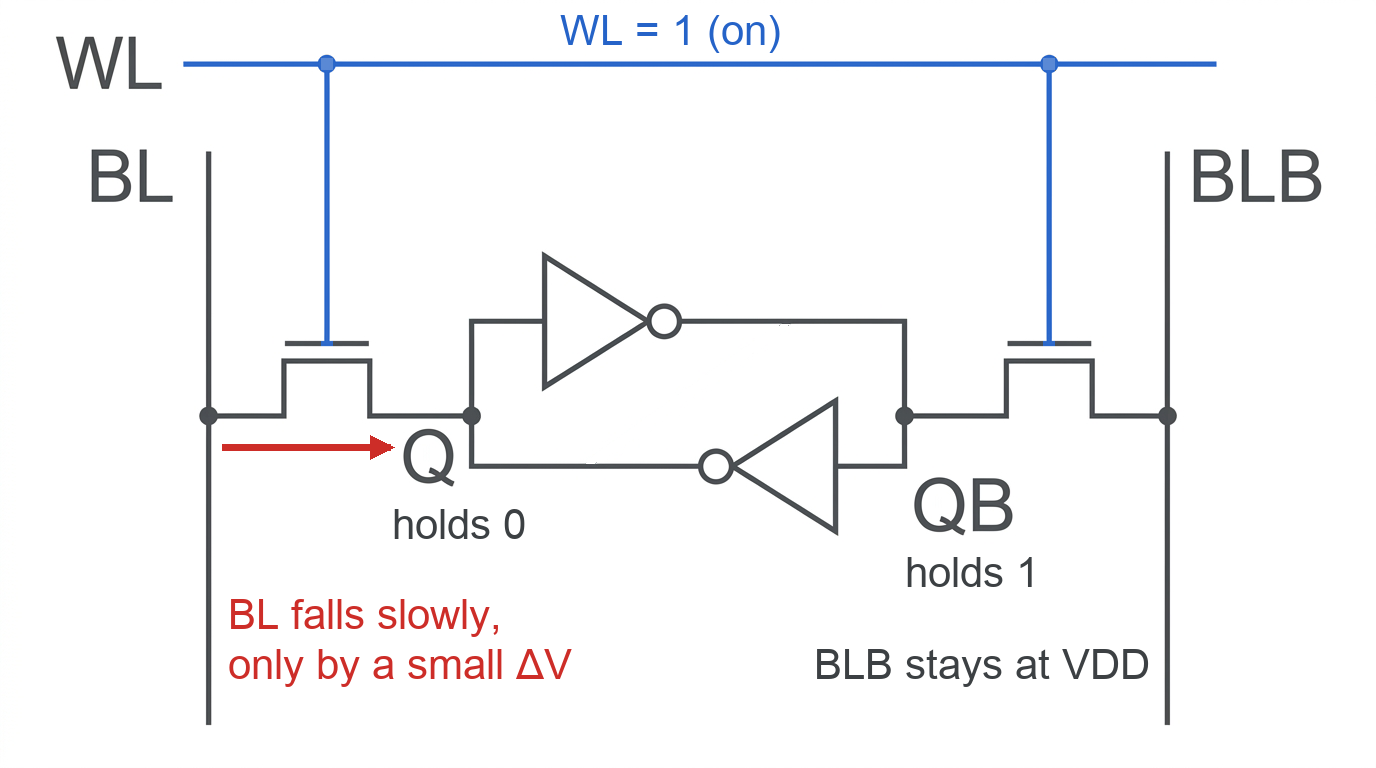
읽기 전에는 BL과 BLB를 모두 VDD로 precharge해 둔다. Q가 0을 담은 cell의 WL을 열면, BL에서 access transistor를 지나 Q로, 다시 아래쪽 inverter의 nMOS를 지나 ground로 전류가 흐르면서 BL이 내려간다. QB는 1이라 BLB는 VDD에 머문다. bitline에는 같은 column의 cell 수백 개와 긴 배선이 매달려 있어 capacitance가 크고, cell의 transistor는 면적 때문에 작게 만들어 전류가 작다. 그래서 BL은 천천히 내려가고, 끝까지 내려가기를 기다리는 대신 BL과 BLB 사이에 작은 전압 차 ΔV가 생기면 sense amp가 그것을 키워서 읽는다.
이때 Q도 BL에서 들어오는 전류 때문에 0에서 조금 떠오른다. 이 높이가 위쪽 inverter를 뒤집을 만큼 커지면 읽다가 값이 바뀌므로, Q를 0으로 붙잡는 아래쪽 inverter의 nMOS(pull-down)를 access transistor보다 강하게 만든다(Harris).
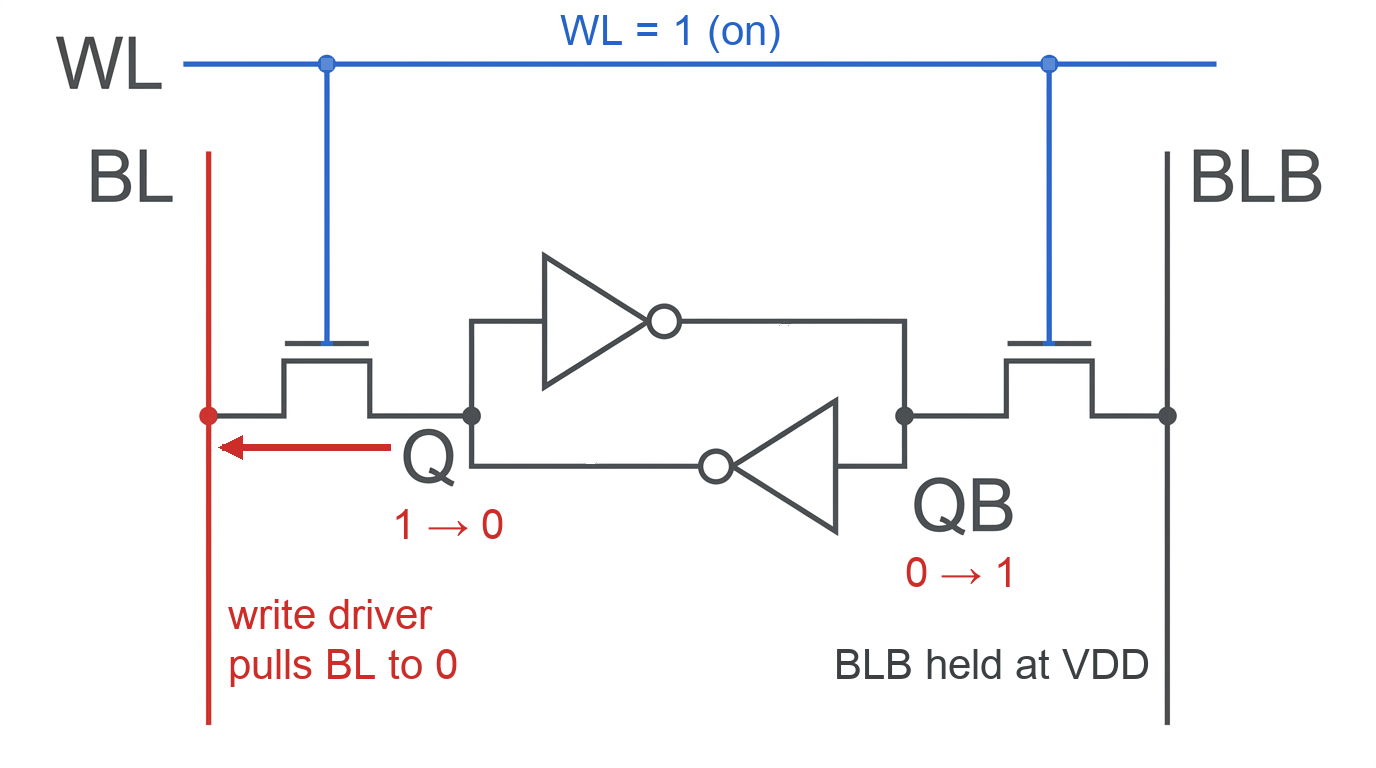
쓰기는 같은 길을 반대 방향으로 쓴다. 먼저 Q가 1인 cell에 0을 쓰는 경우다. write driver가 BL을 0 V로, BLB를 VDD로 붙잡은 채 WL을 연다. precharge는 read를 위한 준비라서, write에서 VDD 쪽 bitline을 붙잡는 것도 precharge가 아니라 write driver다(Harris). write driver는 cell의 transistor보다 훨씬 강하게 만들어 bitline을 직접 구동하므로, BL은 cell이 무엇을 담고 있든 0 V에 머문다(Wikipedia). 이제 전류는 Q에서 access transistor를 지나 BL로 빠져나간다. Q를 1로 붙잡고 있는 것은 아래쪽 inverter의 pMOS(pull-up) 하나인데, 이것을 access transistor보다 약하게 만들어 두었으므로 줄다리기에서 지고 Q가 내려간다. Q가 위쪽 inverter의 switching 전압 아래로 내려가면 그 inverter가 QB를 1로 올리고, 1이 된 QB가 아래쪽 inverter를 통해 Q를 0으로 끌어내리면서 두 inverter가 새 값으로 굳는다. 그 뒤 WL을 닫아도 cell은 새 값을 붙잡는다.
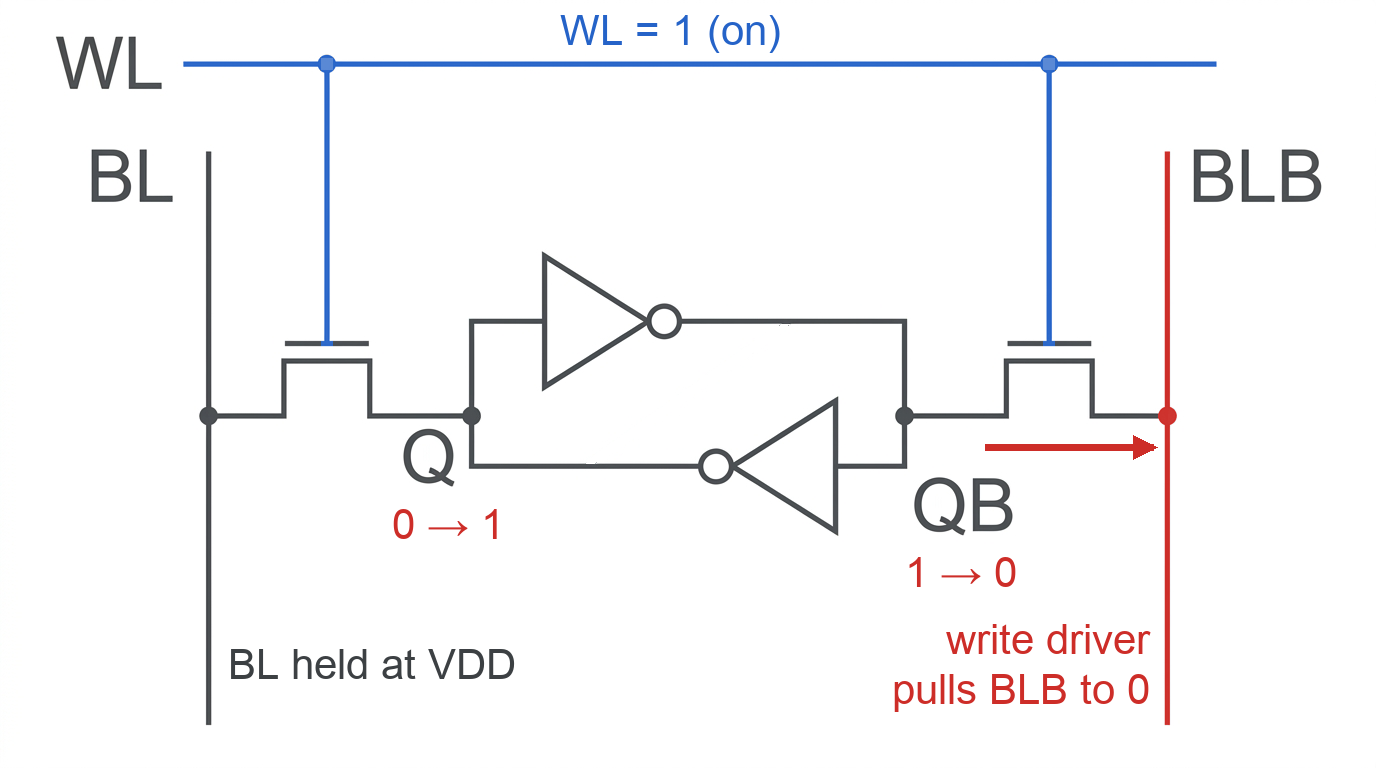
Q가 0인 cell에 1을 쓸 때는 좌우가 바뀐다. write driver가 BL을 VDD로, BLB를 0 V로 붙잡은 채 WL을 열면, 이번에는 QB에서 access transistor를 지나 BLB로 전류가 빠져나간다. QB를 1로 붙잡고 있던 위쪽 inverter의 pMOS가 줄다리기에서 지면서 QB가 내려가고, QB가 아래쪽 inverter의 switching 전압 아래로 내려가면 그 inverter가 Q를 1로 올린다. 1이 된 Q가 위쪽 inverter를 통해 QB를 0으로 끌어내리면서 cell은 Q가 1인 상태로 굳는다. Harris의 강의 자료도 1을 쓰는 예를 이 순서, 곧 QB가 먼저 0으로 끌려 내려가고 Q가 뒤따라 올라가는 순서로 설명한다(Harris).
읽기는 cell이 bitline을 조금 움직이는 일이고, 쓰기는 bitline이 cell을 뒤집는 일이다. 읽을 때 VDD에 있는 bitline은 cell을 뒤집으면 안 되고, 쓸 때 0 V로 내려간 bitline은 cell을 뒤집어야 하므로, 6T cell의 transistor는 pull-down이 가장 강하고 access가 그다음, pull-up이 가장 약하도록 크기를 정한다(Harris). 1을 쓸 때 VDD인 BL로 Q를 직접 밀어 올리지 않는 이유도 여기에 있다. Q를 0으로 붙잡는 pull-down이 access transistor보다 강하니 VDD인 BL은 Q를 뒤집지 못한다. 그래서 write는 0이든 1이든 언제나 0 V로 내려간 bitline 쪽에서 일어나고, Q에 1을 쓰는 일은 QB에 0을 쓰는 일과 같다.
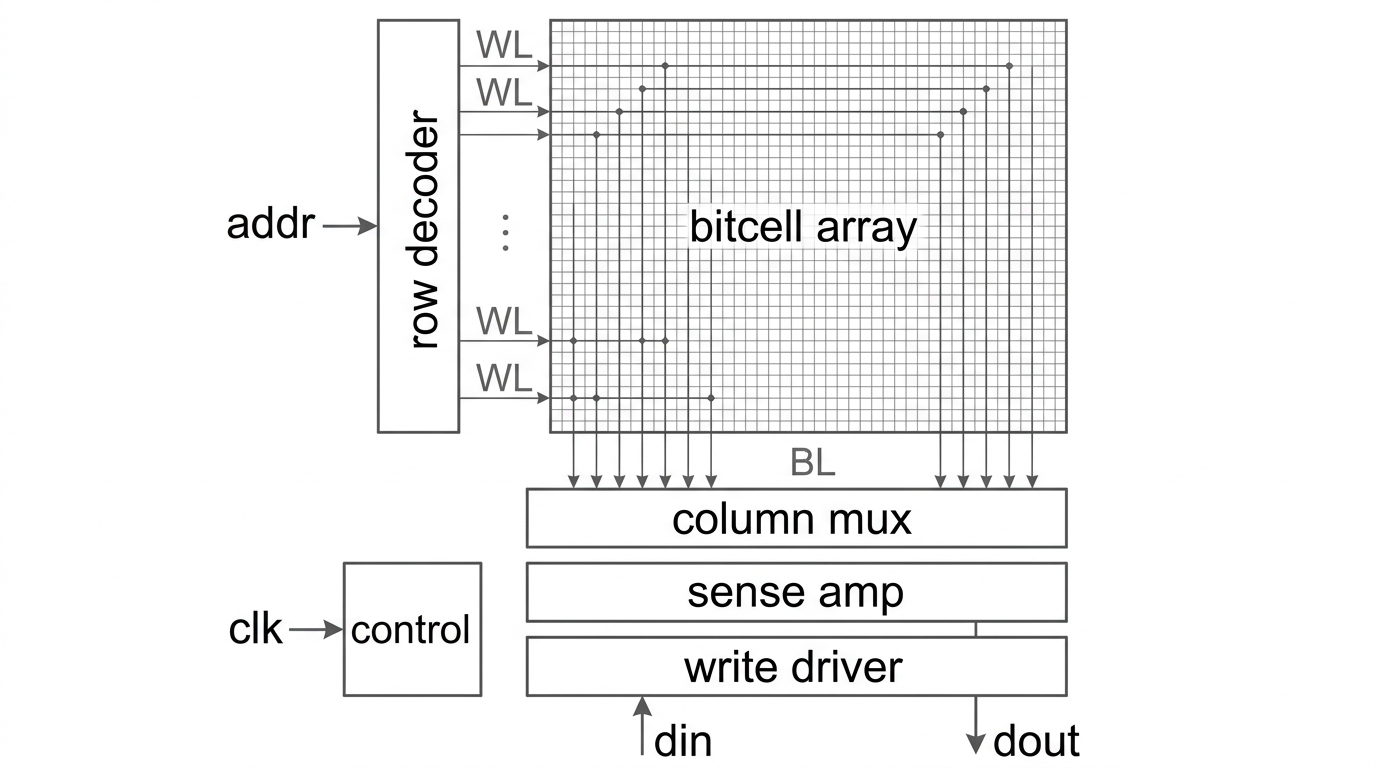
macro 전체의 구성이다. row decoder가 address로 WL 하나를 켜고, bitcell array의 BL은 column mux를 지나 sense amp로 간다. 쓸 때는 write driver가 앞에서 본 것처럼 bitline 한쪽을 0 V로 끌어내린다. control은 clk를 받아 precharge, WL, sense amp, write driver를 켜고 끄는 순서를 만든다. write로 0 V까지 내려간 bitline을 다음 read 전에 VDD로 되돌려 놓는 것도 precharge의 몫이다.
control이 가장 조심해서 정하는 것은 sense amp를 켜는 시점이다. sense amp는 BL과 BLB 가운데 어느 쪽이 낮은지 비교하는 회로인데, 좌우의 transistor가 똑같이 만들어지지 않아 처음부터 한쪽으로 조금 기울어 있다. 이 기울기를 offset이라고 하고, bitline 차이가 offset보다 작을 때 켜면 기울어진 쪽으로 틀린 값을 읽는다. 원인은 transistor마다 threshold voltage(Vth)가 조금씩 다르다는 데 있다. Pelgrom은 1989년 논문에서 transistor 쌍의 Vth 차이가 면적의 제곱근에 반비례한다는 것을 측정으로 보이면서, memory의 read와 write 회로를 matching이 중요한 예로 들었다(JSSC 1989). transistor를 작게 만들수록 offset은 커지는 셈이고, SRAM yield를 다룬 OpenYield는 sense amp offset의 표준편차를 약 20 mV로 잡는다.
그래서 sense amp는 cell이 bitline을 offset보다 충분히 내린 뒤에 켜야 하지만, 너무 기다리면 그만큼 느려진다. 어려운 점은 bitline이 내려가는 속도가 공정과 전압, 온도에 따라 달라진다는 것이다. 이 시점을 inverter 몇 단의 delay로 만들면 조건이 바뀔 때 두 delay가 서로 다르게 변한다. Amrutur는 Stanford 박사 논문에서 bitline delay와 inverter chain delay의 비가 조건에 따라 두 배까지 달라진다고 보였다. memory cell의 delay는 주로 nMOS의 Vth를 따르는데 inverter chain은 nMOS와 pMOS를 함께 따르기 때문이다. 그가 제안한 방법은 replica cell로 만든 replica bitline을 하나 더 두고, 그것이 내려가는 것을 보고 sense amp를 켜는 것이다. 같은 cell로 만든 선이라 조건이 바뀌어도 실제 bitline과 함께 움직이고, 이렇게 만든 회로는 bitline delay를 10% 안쪽으로 따라갔다(Amrutur 1999). OpenRAM의 control logic도 bitcell column 하나를 본뜬 replica bitline으로 sense amp enable을 만든다(OpenRAM 문서).
사양은 메모리 컴파일러에 넣는 값으로 정한다
SRAM macro는 설계자가 transistor를 직접 그려 만들지 않는다. foundry나 IP 회사가 주는 메모리 컴파일러에 몇 가지 값을 넣으면 layout과 timing model이 함께 나온다. 그래서 SRAM의 사양을 정한다는 것은 컴파일러의 옵션을 고르고, 그 macro를 어느 전압에서 돌릴지 정하는 일이다. 컴파일러마다 이름은 조금씩 다르지만 넣는 값과 나오는 파일은 대개 그림과 같다.
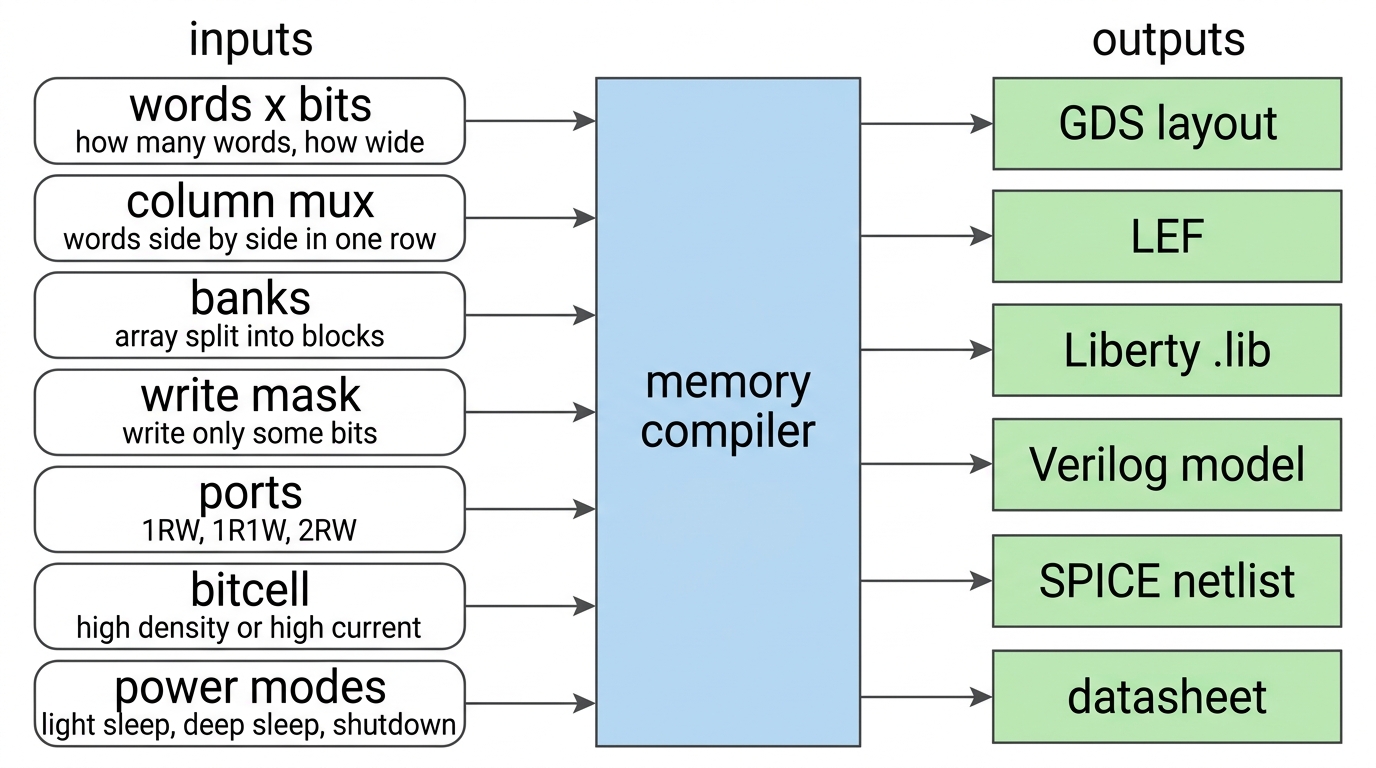
왼쪽 일곱 가지가 사양이다. 컴파일러는 이 값에 맞춰 bitcell을 깔고 둘레 회로를 붙인 뒤, 칩에 넣을 layout(GDS), P&R용 LEF, STA용 Liberty .lib, simulation용 Verilog model, 회로 검증용 SPICE netlist, datasheet를 한 묶음으로 내준다. 입력마다 정할 때 볼 것은 다음과 같다.
| 입력 | 뜻 | 정할 때 볼 것 |
|---|---|---|
| words × bits | word 수와 word 폭 | 용량, bus 폭 |
| column mux | 한 row에 word 몇 개를 나란히 둘지 | array의 모양, 속도, 전력 |
| bank | array를 몇 덩어리로 나눌지 | bitline 길이, 면적 |
| bit-write(write mask) | word의 일부 bit만 쓰기 | byte 단위 쓰기가 필요한 곳 |
| port | 1RW, 1R1W, 2RW처럼 동시에 접근하는 길의 수 | 동시 접근, 면적 |
| bitcell | high density와 high current 같은 cell 종류 | 면적 대 속도 |
| 저전력 mode | light sleep, deep sleep, shutdown 같은 대기 상태 | 대기 leakage, 값 유지 여부 |
저전력 mode는 macro에 control pin을 더하는 옵션이다. 한 사례 보고에 따르면 light sleep은 array의 source bias로, deep sleep은 여기에 둘레 회로의 전원 차단을 더해 leakage를 줄인다. 40 nm와 28 nm low power 공정에서 light sleep은 leakage를 42%, deep sleep은 66~76% 줄였다(Design And Reuse). shutdown은 array의 전원까지 끊어 값을 잃는 대신 leakage가 가장 적다(AnySilicon).
상용 컴파일러의 결과는 공개되지 않으므로 이 글은 공개된 두 가지로 방향을 확인한다. 하나는 OpenRAM이 SkyWater 130 nm 공정으로 만들어 공개한 macro이고, 다른 하나는 HP Labs의 SRAM과 cache 모델인 CACTI 7이다. 숫자는 모델과 공정에 따라 달라지므로 방향만 보면 된다. OpenRAM은 사양을 Python 설정 파일로 받는다. 아래는 앞에서 LEF를 본 1 KB macro의 설정에서 주석을 뺀 것이다. read와 write를 하는 port 하나와 read만 하는 port 하나를 가진 두 port macro이고, 8 bit 단위로 쓸 수 있다.
word_size = 32 # Bits
num_words = 256
human_byte_size = "{:.0f}kbytes".format((word_size * num_words)/1024/8)

# Allow byte writes
write_size = 8 # Bits

# Dual port
num_rw_ports = 1
num_r_ports = 1
num_w_ports = 0
ports_human = '1rw1r'

import os
exec(open(os.path.join(os.path.dirname(__file__), 'sky130_sram_common.py')).read())
OpenRAM도 이 설정 하나로 그림 오른쪽의 파일을 모두 만들고, Liberty .lib는 corner마다 따로 낸다.
column mux는 따로 주지 않았다. OpenRAM이 word 수와 폭을 보고 정한다. 같은 저장소에는 같은 1 KB를 32 bit × 256 word와 8 bit × 1,024 word로 만든 macro가 함께 있고, 두 log에는 다음 줄이 남아 있다(sky130_sram_macros).
$ grep 'Rows:\|^Words per row' sky130_sram_1kbyte_1rw1r_32x256_8.log
[sram_config/recompute_sizes]: Rows: 128 Cols: 64
Words per row: 2
$ grep 'Rows:\|^Words per row' sky130_sram_1kbyte_1rw1r_8x1024_8.log
[sram_config/recompute_sizes]: Rows: 128 Cols: 64
Words per row: 8
두 macro의 bitcell array는 128 row × 64 column으로 같고, column mux만 2와 8로 다르다. word가 좁은 쪽은 한 row에 word 8개가 들어가므로 8:1 mux로 하나를 고른다. 공개된 layout의 크기는 32 bit 쪽이 479.78 × 397.5 µm(190,713 µm²), 8 bit 쪽이 455.3 × 446.46 µm(203,273 µm²)로, 용량이 같아도 모양과 면적이 다르다. 같은 저장소의 2 KB macro(32 bit × 512 word, mux 4, array 128 × 128)는 284,538 µm²다. 용량은 두 배인데 면적은 1.49배다. 이 크기에서는 bitcell보다 둘레 회로가 면적의 큰 몫을 차지한다는 뜻이다.
column mux는 array의 모양을 정하고, 속도와 면적에는 최적점이 있다
column mux가 하는 일은 array를 접는 것이다. 64 bit × 1,024 word를 접지 않고 쌓으면 row 1,024개, column 64개인 가늘고 긴 array가 되고, bitline 하나에 cell 1,024개가 매달린다. mux 8을 쓰면 한 row에 word 8개를 나란히 놓는다. row는 128개로 줄고 column은 512개로 늘며, 읽을 때는 WL로 row 하나를 연 뒤 column mux가 bit마다 column 8개 가운데 하나를 골라 sense amp로 보낸다. word 수가 word 폭보다 훨씬 많으면 이렇게 접어서 row를 줄이고 column을 늘린다(Harris).
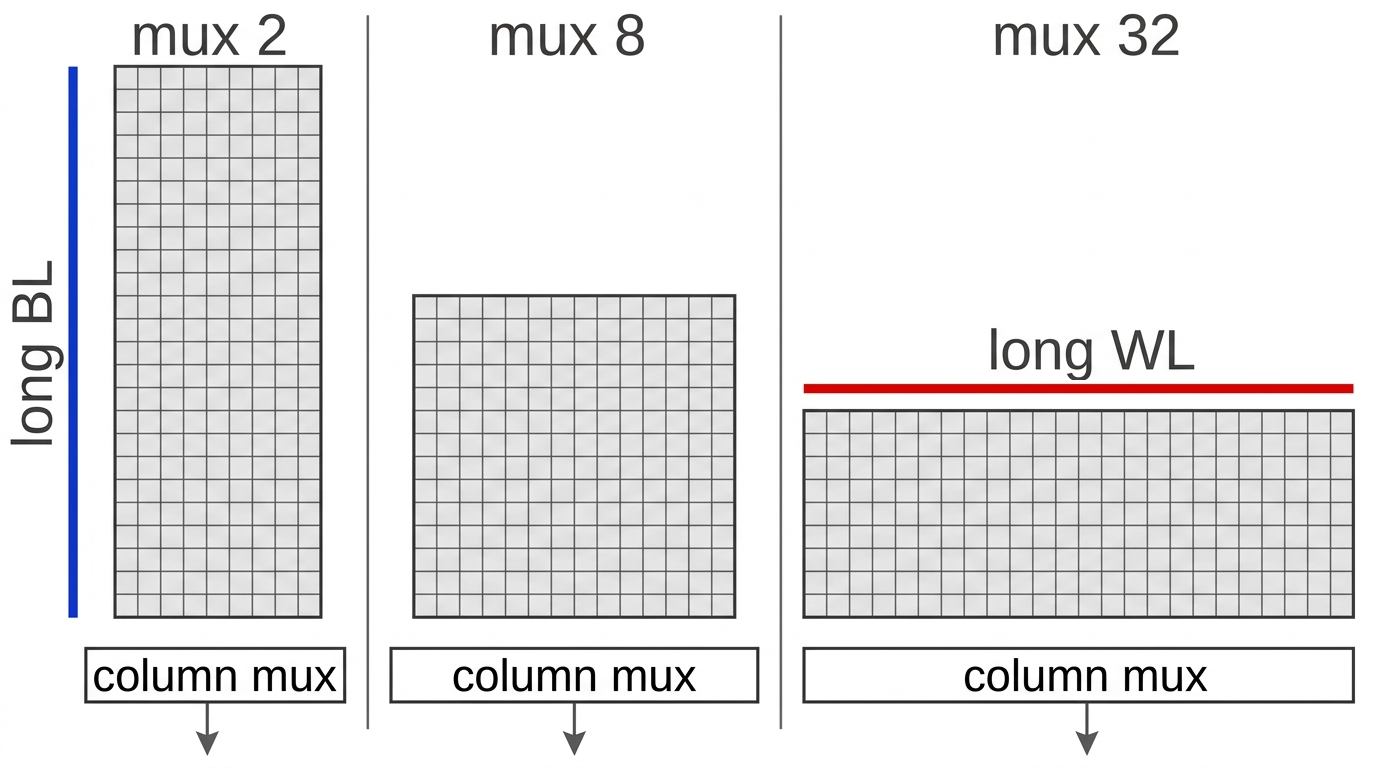
그림은 용량이 같은 array를 mux 2, 8, 32로 접었을 때의 모양을 단순하게 그린 것이다. mux가 낮으면 세로로 길어 bitline이 길고, 높으면 가로로 넓어 wordline이 길다. 아래쪽 column mux의 폭도 array를 따라 넓어진다.
이 8 KB(64 bit × 1,024 word)를 CACTI 7의 22 nm 모델에 넣고 column mux만 바꿔 봤다. 소자는 ITRS high-performance, array는 subarray 2 × 2로 고정했고 표의 row와 column은 subarray 하나의 크기다.
| column mux | subarray (row × column) | access time (ns) | bitline delay (ns) | 면적 (µm²) | 세로 × 가로 (µm) | read energy (pJ) |
|---|---|---|---|---|---|---|
| 2 | 512 × 32 | 0.337 | 0.160 | 6,525 | 340 × 19 | 1.19 |
| 4 | 256 × 64 | 0.183 | 0.078 | 6,054 | 175 × 35 | 1.28 |
| 8 | 128 × 128 | 0.135 | 0.044 | 6,272 | 94 × 67 | 1.50 |
| 16 | 64 × 256 | 0.129 | 0.033 | 6,829 | 53 × 128 | 2.05 |
| 32 | 32 × 512 | 0.182 | 0.042 | 8,383 | 34 × 246 | 3.10 |
read energy는 mux를 올릴수록 늘어 mux 32에서 mux 2의 2.6배다. WL 하나를 켜면 그 row의 모든 column이 bitline을 내리는데, 그중 읽는 것은 mux분의 1뿐이기 때문이다. access time과 면적은 한 방향으로 움직이지 않는다. mux 2는 bitline 하나에 cell이 512개 매달려 bitline delay가 가장 길고, mux 32는 wordline이 길어져 decoder와 wordline의 delay가 다시 는다. 이 모델에서는 access time이 mux 8과 16에서, 면적이 mux 4에서 가장 작았다. 모양도 세로로 긴 340 × 19 µm에서 가로로 긴 34 × 246 µm까지 바뀌므로, floorplan에서 macro가 들어갈 자리의 모양도 mux를 고르는 이유가 된다.
bank로 bitline을 나누면 bitline은 빨라지지만 둘레 회로가 늘어난다
용량이 커지면 bitline 하나에 매달리는 cell 수를 줄이려고 array를 위아래로 나누고 덩어리마다 sense amp를 둔다. 컴파일러의 bank 옵션이 이 일을 한다.

왼쪽은 512 row짜리 array 하나에 sense amp 한 줄을 둔 것이고, 오른쪽은 같은 cell을 128 row씩 네 덩어리로 나눠 덩어리마다 sense amp를 둔 것이다. bitline 하나에 매달린 cell은 4분의 1이 되지만 sense amp는 네 줄이 된다.
64 KB(64 bit × 8,192 word)를 같은 모델에 넣고 subarray 하나의 row 수만 512에서 32까지 줄여 봤다 (CACTI의 Ndbl을 2에서 32까지 바꾼 것이다).
| subarray row 수 | access time (ns) | bitline delay (ns) | 면적 (µm²) | bitcell 면적 비율 | read energy (pJ) | leakage (mW) |
|---|---|---|---|---|---|---|
| 512 | 0.371 | 0.162 | 43,726 | 85% | 8.06 | 18.77 |
| 256 | 0.322 | 0.087 | 49,889 | 74% | 5.73 | 18.85 |
| 128 | 0.345 | 0.051 | 56,089 | 66% | 4.69 | 19.00 |
| 64 | 0.389 | 0.033 | 65,065 | 57% | 4.45 | 19.24 |
| 32 | 0.460 | 0.024 | 80,998 | 46% | 4.77 | 19.69 |
bitline delay는 0.162 ns에서 0.024 ns로 7분의 1이 된다. 그런데 access time은 row 256에서 가장 짧고, 그보다 더 나누면 오히려 늘어 row 32에서는 0.460 ns다. 덩어리가 많아지면 address와 data를 덩어리까지 나르는 배선(CACTI의 H-tree)이 길어지기 때문이다. 면적은 43,726 µm²에서 80,998 µm²로 85% 늘고, 그중 bitcell이 차지하는 비율은 85%에서 46%로 떨어진다. read energy는 짧아진 bitline 덕에 줄다가 row 64를 지나며 다시 는다. leakage는 5% 남짓 늘어 거의 그대로다.
wordline 쪽에도 같은 생각이 있다. Yoshimoto 등이 1983년에 발표한 divided word-line은 wordline을 나눠 계층적으로 선택하는 구조로, 면적 부담이 적으면서 VLSI SRAM의 문제를 푸는 방법으로 소개됐다(JSSC 1983). 어느 쪽이든 나누면 선은 짧아지고 둘레 회로와 배선이 늘어나는 거래다.
bitcell은 high density와 high current 가운데 고르고, 아주 작은 memory는 FF로 만든다
같은 6T라도 transistor 크기를 다르게 한 cell이 여러 가지다. FinFET에서는 fin 수가 transistor 폭이므로, 가장 작은 high density cell은 transistor를 모두 fin 하나로 만들고, high current cell은 그중 두 쌍을 fin 두 개로 만든다(IEEE Spectrum). 전류가 큰 만큼 bitline을 빨리 내리고 낮은 전압에서도 잘 버티지만 cell이 커진다. Intel이 ISSCC 2025에서 발표한 18A의 bitcell은 high current가 0.023 µm², high density가 0.021 µm²였다(Semiecosystem).
cell 면적이 중요한 것은 SRAM이 logic만큼 줄지 않기 때문이다. TSMC의 high density bitcell은 N5에서 0.021 µm²였고, N3의 첫 버전(N3B)에서 0.0199 µm²로 5% 줄었다가 N3E에서는 다시 0.021 µm²로 N5와 같아졌다(SemiAnalysis). WikiChip이 가정한 100억 transistor 칩에서 SRAM이 차지하는 면적은 N16에서 17.6%, N5에서 22.5%, N3에서 28.6%로 커진다(TechSpot).
반대로 용량이 아주 작으면 SRAM macro가 손해다. 앞의 OpenRAM macro처럼 작은 macro에서는 둘레 회로가 면적의 큰 몫을 차지하기 때문이다. 이때는 FF나 latch를 standard cell로 엮은 standard cell memory를 쓴다. 저전력 가속기 설계를 다룬 한 논문은 1 kb까지는 standard cell memory가 SRAM보다 작지만, 4 kb에서는 이미 2~3배 크다고 정리했다(arXiv 2106.12810). 이 경계는 공정과 컴파일러에 따라 다르므로, 수백 byte 근처의 memory는 두 방식을 모두 뽑아 비교해 보는 편이 좋다.
같은 macro가 OD에서는 timing을 맞추고 NM에서는 못 맞추는 이유
foundry와 IP 회사는 같은 library를 여러 전압에서 characterize해 준다. Synopsys도 자사 standard cell library를 소개하면서 저전압과 overdrive PVT를 포함한 multi-VDD characterization을 내세운다(Synopsys). 흔히 기준 전압을 NM(nominal), 높인 전압을 OD(overdrive), 낮춘 전압을 UD(underdrive)라고 부르고, 메모리 컴파일러도 전압마다 timing model을 따로 낸다.
그러다 보면 같은 macro가 같은 주파수에서 OD로는 맞는데 NM으로는 못 맞추는 일을 겪는다. 전압이 10%가량 내려갔을 뿐인데 memory가 logic보다 먼저 timing을 놓치는 데는 두 가지 이유가 있다.
첫째는 transistor 전류다. 전압을 내리면 모든 transistor의 전류가 줄어 회로가 느려진다. 그런데 logic은 신호가 오르내려야 할 폭도 VDD라서 함께 줄고, 손해가 일부 상쇄된다. bitline은 다르다. 읽는 데 필요한 bitline 차이 ΔV는 sense amp의 offset이 정하므로 전압을 내려도 줄지 않고, 전류가 준 만큼 그대로 느려진다.
식으로 쓰면 이렇다. Sakurai와 Newton의 alpha-power 모델에서 gate delay는 VDD/(VDD−Vth)^α에 비례하고, α는 velocity saturation이 강한 소자의 1에서 거의 없는 소자의 2 사이 값이다(Adler와 Friedman의 정리). bitline이 ΔV에 닿는 시간은 C·ΔV/I_cell이고 I_cell은 (VDD−Vth)^α에 비례하므로, logic과 달리 분자에 VDD가 없다.
| 전압 | logic delay (OD = 1) | bitline이 ΔV에 닿는 시간 (OD = 1) | 동적 전력 (NM = 1) |
|---|---|---|---|
| OD 0.85 V | 1.00 | 1.00 | 1.28 |
| NM 0.75 V | 1.18 | 1.34 | 1.00 |
| UD 0.65 V | 1.49 | 1.94 | 0.75 |
Vth 0.35 V, α 1.3을 넣어 계산한 값이다. 설명을 위해 고른 숫자라 실제 공정과는 다르지만 방향은 분명하다. NM으로 내려가면 logic은 18% 느려지는데 bitline은 34% 느려진다. OD에서 여유가 조금밖에 없던 memory path는 NM에서 먼저 넘친다.
둘째는 산포다. Amrutur는 delay의 상대 산포가 gate overdrive, 곧 VDD−Vth에 반비례한다고 정리했다. 전압을 내리면 같은 Vth 산포가 더 큰 delay 산포가 된다. macro 안에는 수십만 개의 cell이 있고 timing은 그중 가장 약한 cell이 정하므로, 이 효과는 평균보다 꼬리에서 크게 나타난다. near-threshold 영역을 다룬 한 연구는 VDD를 0.7 V에서 0.5 V로 내리면 수율 조건을 만족하는 SRAM access time이 7.85배가 되고, 그 때문에 SRAM의 최저 동작 전압(Vmin)이 logic보다 100~200 mV 높아진다고 했다(arXiv 2202.11941). signoff는 여기에 가장 느린 공정 corner와 온도를 겹치므로, NM에서 실패했다는 것은 대개 느린 corner와 NM 전압이 만나는 조건에서 실패했다는 뜻이다.
전압을 올리기 전에 macro의 구성부터 다시 본다
OD는 가장 쉬운 해결처럼 보이지만 비용이 크다. 동적 전력은 αCV²f라서 위 예처럼 0.75 V에서 0.85 V로 올리면 28% 는다. leakage도 VDD를 따라 늘어나는데, DIBL 때문에 subthreshold 전류는 전압에 지수적으로 반응한다(Butzen). memory만 OD로 돌리려면 별도 power domain과 level shifter도 필요하다.
그래서 순서는 반대가 낫다. 먼저 bank를 늘려 bitline을 짧게 하고, column mux를 바꿔 array의 모양을 다시 잡는다. 컴파일러가 high current bitcell을 준다면 그것으로 바꿔 본다. 그래도 안 되면 memory 출력을 바로 쓰지 않고 FF를 한 단 거쳐 쓰도록 pipeline을 나눈다. 앞의 CACTI 결과처럼 이 손잡이들에도 최적점이 있으므로, 한쪽으로 끝까지 돌리지 말고 몇 가지 조합을 컴파일러로 뽑아 비교하는 것이 빠르다.
| 바꾸는 것 | 면적 | 속도 | 동적 전력 |
|---|---|---|---|
| column mux를 올림 | 줄다가 다시 는다 | bitline은 빨라지고 wordline은 느려져 최적점이 있다 | 는다 |
| bank로 bitline을 나눔 | 는다 | bitline은 빨라지지만 배선이 늘어 최적점이 있다 | 줄다가 다시 는다 |
| OD로 올림 | 그대로 | 빨라진다 | 전압의 제곱으로 는다 |
| NM, UD로 내림 | 그대로 | bitline이 logic보다 더 느려진다 | 준다 |
지금까지 본 것을 한 표로 모았다. 좋은 SRAM 사양은 가장 작은 macro도, 가장 빠른 macro도 아니고, 그 칩이 면적과 속도, 전력 가운데 무엇을 먼저 보는지를 반영한 입력값이다. 특히 동작 전압은 컴파일러 옵션과 따로 정하는 값이 아니어서, NM에서 timing이 빠듯하다면 전압보다 macro의 구성을 먼저 다시 보는 편이 비용이 적다.
참고 자료
- Wikipedia, Static random-access memory
- D. Harris, CMOS VLSI Design 4th Ed. Lecture 19: SRAM (Harvey Mudd College)
- M. J. S. Smith, Application-Specific Integrated Circuits (Addison-Wesley, 1997)
- Wikipedia, Application-specific integrated circuit (hard and soft macros)
- SkyWater sky130_fd_sc_hd standard cell library, inv_1 LEF
- CACTI 7 (HP Labs), cache and memory model
- OpenRAM, open-source memory compiler (VLSIDA)
- VLSIDA sky130_sram_macros (OpenRAM macros for SkyWater 130 nm)
- B. S. Amrutur, Design and Analysis of Fast Low Power SRAMs (Stanford Ph.D. dissertation, 1999)
- M. Pelgrom et al., Matching Properties of MOS Transistors (IEEE JSSC, 1989)
- OpenYield, An Open-Source SRAM Yield Analysis and Optimization Benchmark Suite (arXiv 2508.04106)
- A Timing Yield Model for SRAM Cells in Sub/Near-threshold Voltages (arXiv 2202.11941)