
setup/hold 위반이 어떤 경로에서 생기고 PD에서 어떻게 고치는지, clock을 늦추면 왜 setup만 풀리는지 정리한다. 이어서 clock을 바꿀 때 mux에 생기는 glitch와 이를 막는 glitch-free clock mux를 RTL로 본다.
SoC는 동작 중에 clock을 바꾼다. 전원이 들어오면 PLL이 lock될 때까지 oscillator clock으로 돌다가 PLL 출력으로 넘어가고, 할 일이 적을 때는 느린 clock으로 내려간다. 이때 따질 것은 두 가지다. 느린 clock으로 바꾸면 timing 문제 가운데 무엇이 풀리는가, 그리고 바꾸는 순간 clock 선에는 무슨 일이 생기는가. FF의 기본 동작은 FSM 글에서, glitch와 clock gating은 ICG 글에서 다뤘다.
FF가 clock edge 앞뒤로 요구하는 두 시간
edge-triggered FF가 D를 제대로 capture하려면 clock edge 앞뒤로 D가 움직이지 않아야 하는 구간이 있다. edge 전에 D가 미리 안정돼 있어야 하는 최소 시간이 setup time(t_su)이고, edge가 지난 뒤에도 D가 유지돼야 하는 최소 시간이 hold time(t_h)이다.

D가 edge보다 t_su 이상 먼저 안정되고 edge 뒤로 t_h가 지날 때까지 값을 유지하면 FF는 그 값을 capture한다. 이 구간 안에서 D가 바뀌면 FF 출력이 0과 1 사이에서 한동안 정해지지 않는 metastability에 빠질 수 있고, 끝내 어느 값으로 정해질지도 보장되지 않는다.
setup은 다음 edge와, hold는 같은 edge와 겨룬다
STA는 FF 두 개 사이의 경로마다 이 두 조건을 검사한다. 앞 FF(launch FF)가 clock edge에서 내보낸 값이 combinational logic을 지나 뒤 FF(capture FF)의 D에 도착하는 시간과, clock이 두 FF에 도착하는 시간을 비교한다.
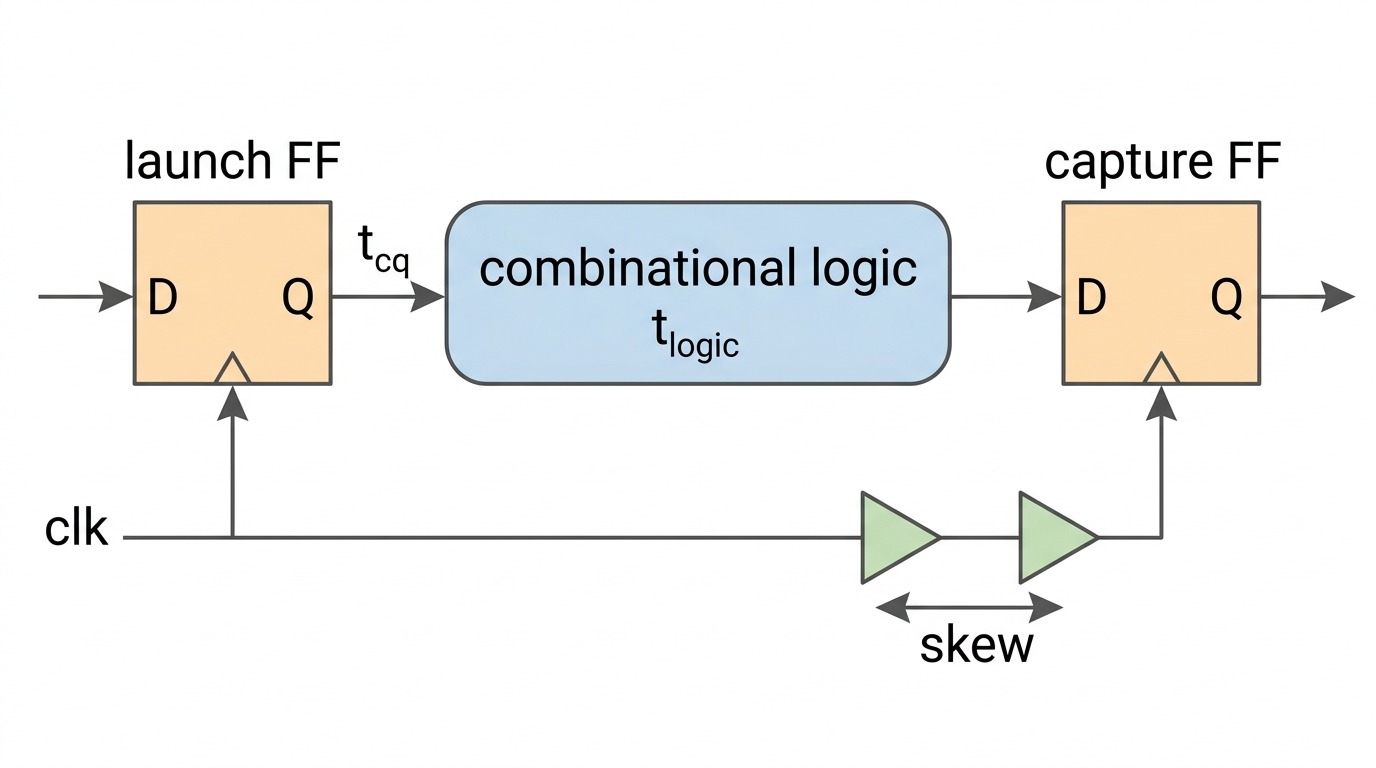
clock은 같은 source에서 출발하지만 buffer와 배선을 거치는 길이가 달라 두 FF에 도착하는 시각이 조금씩 다르다. capture FF 쪽 clock이 launch FF 쪽보다 늦게 도착하는 만큼을 skew(t_skew)라고 하면, 두 조건은 다음과 같이 쓸 수 있다.
setup:  T_clk >= t_cq + t_logic(max) + t_su - t_skew
hold :  t_cq + t_logic(min) >= t_h + t_skew
t_cq는 launch FF가 edge를 받고 Q를 내보내기까지의 delay, t_logic은 combinational logic의 delay다. setup 식은 가장 느린 경로(max)가 다음 edge보다 t_su 앞서 도착하는지를 본다. 그래서 clock 주기 T_clk가 식에 들어 있다. hold 식은 가장 빠른 경로(min)가, capture FF가 같은 edge에서 방금 받은 값을 t_h가 지나기 전에 덮어쓰지 않는지를 본다. launch와 capture가 같은 edge에서 일어나는 일이라 식에 T_clk가 없다. skew는 두 식에 반대 방향으로 들어간다. capture 쪽 clock이 늦으면 setup에는 여유가 생기고 hold에는 여유가 줄어든다.
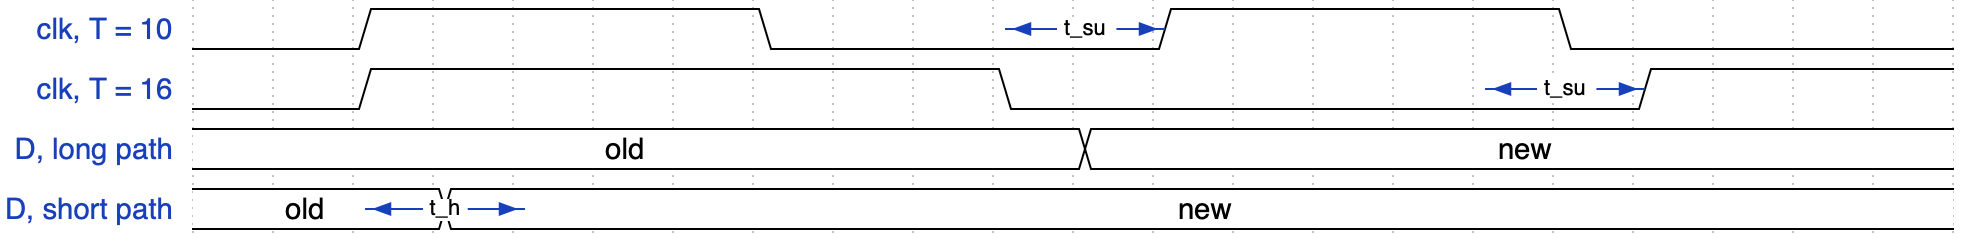
위 두 줄은 주기만 다른 clock이고, 아래 두 줄은 첫 rising edge에서 출발한 데이터가 capture FF의 D에 도착하는 모습이다. 긴 경로를 지난 데이터는 T = 10인 clock에서는 다음 edge 직전의 setup 구간 안에 도착해 위반이 되고, T = 16으로 늦추면 setup 구간보다 앞서 도착해 통과한다. 짧은 경로를 지난 데이터는 출발한 edge 직후의 hold 구간 안에서 바뀐다. 이 구간은 다음 edge가 아니라 출발한 edge에 붙어 있어서 clock을 늦춰도 그대로다.
위반은 어떤 경로에서 생기나
STA 리포트에서 slack이 음수인 경로가 위반이다. setup slack은 데이터가 도착해야 하는 시각(required time)에서 실제 도착 시각(arrival time)을 뺀 값이고, hold slack은 반대로 실제 도착 시각에서 요구 시각을 뺀 값이다. 둘 다 0 이상이어야 통과한다.
setup 위반은 한 주기 안에 너무 많은 일을 하는 경로에서 나온다. 곱셈기나 깊은 mux tree처럼 logic 단수가 많은 경로, block 사이를 길게 가로지르는 배선, fanout이 큰 net이 대표적이다. 공정이 미세해질수록 배선 delay의 비중이 커져서, RTL에서는 짧아 보이던 경로가 배치 뒤에 위반이 되기도 한다.
hold 위반은 반대로 사이에 logic이 거의 없는 경로에서 나온다. FF의 Q가 바로 다음 FF의 D로 들어가는 shift register나, 양산 test용 scan chain(한 FF의 Q가 다음 FF의 scan 입력으로 바로 이어진다)이 대표적이다. 여기에 두 FF의 clock 도착 시각이 크게 어긋나면, 경로 자체는 멀쩡해도 hold가 깨진다.
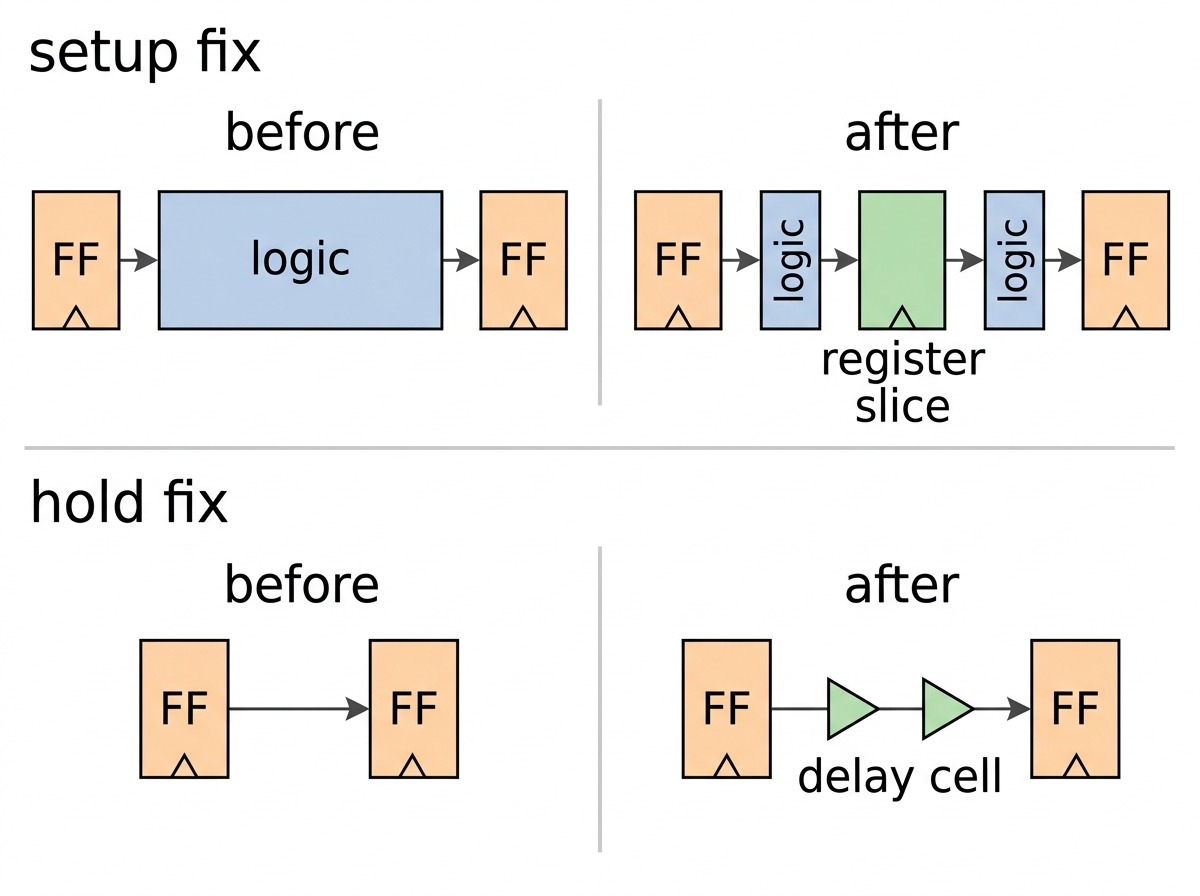
위 칸은 setup, 아래 칸은 hold를 고치는 가장 기본적인 모양이다. setup은 긴 logic 한가운데에 FF를 하나 넣어 경로를 둘로 나누고, hold는 capture FF의 D 바로 앞에 delay cell을 넣어 데이터를 일부러 늦춘다. 실제 PD에서는 이 둘 사이에 훨씬 많은 단계가 있다.
PD에서 setup 위반을 고치는 순서
PD(physical design)는 합성된 netlist를 배치하고(placement), clock tree를 만들고(CTS, Clock Tree Synthesis), 배선하는(routing) 단계다. P&R 툴은 단계마다 timing을 다시 계산해 위반 경로를 고치고, 마지막에 signoff STA로 확인한다. setup을 고치는 방법은 대략 아래 순서로 무거워진다.
먼저 셀 단위로 고친다. 경로 위의 셀을 drive strength가 큰 것으로 바꾸고(upsizing), threshold voltage가 낮은 셀(LVT, ULVT)로 바꿔 delay를 줄인다. 낮은 Vt 셀은 빠른 대신 leakage가 커서 위반 경로에만 골라 쓴다. 긴 배선에는 buffer(repeater)를 중간중간 넣어 배선 delay와 slew를 줄이고, 반대로 buffer가 너무 많이 들어간 경로는 걷어낸다. 입력 pin끼리 바꿔도 되는 gate에서는 늦게 도착하는 신호를 빠른 pin으로 옮기기도 한다(pin swap).
셀 조정으로 모자라면 배치와 배선을 건드린다. 경로에 걸린 셀들을 서로 가깝게 모으고, 중요한 net은 저항이 작은 위쪽의 두꺼운 metal layer로 올려 배선하거나(layer promotion), 선 폭과 간격을 넓힌 규칙(NDR, non-default rule)을 줘서 RC와 crosstalk를 줄인다.
clock 쪽에서도 여유를 만들 수 있다. 앞의 식에서 capture FF의 clock이 늦게 오면 setup 여유가 생기는데, 이것을 일부러 쓰는 것이 useful skew다. capture FF의 clock을 늦추거나 launch FF의 clock을 당겨서 모자란 경로에 시간을 빌려 준다. 대신 그 capture FF에서 출발하는 다음 경로는 그만큼 시간을 잃고, 그 FF의 hold 여유도 줄어든다. 그래서 요즘 P&R 툴은 clock tree를 만들면서 data path 최적화를 함께 한다. Cadence Innovus의 CCOpt(Clock Concurrent Optimization)는 propagated clock을 기준으로 clock tree와 logic delay를 동시에 맞춘다. 위반이 block 사이의 clock 도착 시각 차이에서 온다면 skew 목표나 clock tree 구조를 바꿔 CTS를 다시 잡는다.
여기까지 해도 안 닫히면 PD 안에는 방법이 없고 RTL로 돌아간다. 경로 중간에 FF를 넣어 한 주기의 일을 두 주기로 나누는 pipeline이 기본이다. bus처럼 handshake가 정해진 경로에는 이 용도로 register slice를 끼운다. AMD의 AXI Register Slice IP는 AXI interface 사이에 pipeline register를 넣어 timing을 닫는 데 쓰고, 그 대가로 latency가 늘어난다. 합성 툴의 retiming으로 FF를 logic 사이로 옮겨 앞뒤 경로의 길이를 고르게 만들기도 한다. 그 경로가 기능상 여러 주기에 걸쳐 끝나도 되는 것이라면 multicycle path로 constraint를 고치는 것이 맞는 답이다. 이것들로도 안 되면 마지막 수단이 목표 주파수를 낮추는 것이다.
hold 위반은 CTS 뒤에 delay를 넣어 고친다
hold는 skew에 민감해서, 실제 clock tree가 없는 CTS 전에는 제대로 볼 수 없다. CTS 전의 STA는 모든 FF에 clock이 동시에 도착한다고 보는 ideal clock에 set_clock_uncertainty로 여유만 두고, CTS 뒤에는 clock buffer의 delay가 반영된 propagated clock으로 계산한다. 그래서 hold fix는 보통 CTS 뒤에 시작한다.
방법은 짧은 경로에 delay를 더하는 것이다. capture FF의 D 가까이에 delay cell이나 buffer를 넣고, 경로 위의 셀을 작게 하거나 Vt가 높은 셀로 바꿔 일부러 느리게 만든다. D 가까이에 넣는 이유는 같은 net에서 다른 FF로 가는 경로에 delay가 더해지지 않게 하려는 것이다. 넣은 delay가 setup을 깨면 안 되므로, delay가 가장 짧아지는 fast corner의 hold와 가장 길어지는 slow corner의 setup을 함께 보면서 고친다(MCMM, multi-corner multi-mode).
hold buffer가 수백, 수천 개씩 들어가야 한다면 경로보다 clock tree를 먼저 본다. 두 clock group 사이나 ICG 아래 FF들의 clock 도착 시각이 크게 어긋나 있으면 buffer를 계속 넣기보다 skew 목표를 다시 잡고 CTS를 다시 돌리는 편이 면적과 전력에서 낫다. 배선까지 끝난 뒤 signoff STA에서 남은 위반은 timing ECO로 고친다. PrimeTime의 fix_eco_timing처럼 signoff 툴이 cell sizing과 buffer 삽입을 제안하면, P&R 툴이 배치와 배선을 조금만 바꿔 반영한다.
| 방법 | 고치는 것 | 대가 |
|---|---|---|
| cell upsizing, 낮은 Vt 셀 | setup | 면적, leakage, hold 여유 감소 |
| 긴 배선에 buffer | setup | 면적, 전력 |
| layer promotion, NDR | setup | 위쪽 metal의 배선 자원 |
| useful skew, CTS 재조정 | setup, 때로 hold | 이웃 경로의 여유 |
| pipeline, register slice | setup | latency, RTL 수정 |
| delay cell, cell downsizing | hold | 면적, 전력, setup 여유 감소 |
| 목표 주파수 낮추기 | setup | 성능 |
clock을 늦춰서 고칠 수 있는 것과 없는 것
PD에서 끝내 못 닫은 setup 위반은 clock을 늦추면 풀린다. 목표 주파수에서 setup이 모자란 칩도 주파수를 낮추면 동작하고, 칩을 test에서 통과한 주파수별로 등급을 나눠 팔기도 한다(speed binning).
hold 위반은 경로가 너무 빨라서 생기므로 clock으로는 고칠 수 없다. 식에 T_clk가 없으니 어떤 주파수에서 돌려도 같은 경로가 같은 값을 덮어쓴다. 칩이 나온 뒤 hold 위반이 발견되면 주파수를 아무리 낮춰도 그 경로는 틀린 값을 capture하고, 고치려면 mask를 다시 만들어야 한다. 미리 깔아 둔 spare cell을 metal 배선만 바꿔 쓰는 ECO로 끝나면 비용은 줄지만, 새 mask를 만들고 wafer를 다시 흘려야 한다는 점은 같다. 그래서 hold는 tape-out 전에 반드시 닫는다.
| 구분 | setup 위반 | hold 위반 |
|---|---|---|
| 원인 | 데이터가 너무 늦게 도착(긴 경로) | 데이터가 너무 일찍 바뀜(짧은 경로) |
| 비교하는 edge | 다음 edge | 같은 edge |
| clock을 늦추면 | 풀린다 | 그대로다 |
| PD에서 주로 쓰는 방법 | sizing, buffer, useful skew, pipeline | CTS 뒤 delay cell |
| 칩이 나온 뒤 | 낮은 주파수로 동작 | mask를 다시 만들어야 한다 |
clock을 바꾸는 mux에서 생기는 glitch
주파수를 바꾸는 가장 단순한 방법은 clock 두 개를 mux로 고르는 것이다.
// plain 2:1 mux on a clock path
assign clk_out = sel ? clk1 : clk0;
데이터 경로라면 이것으로 충분하다. mux 출력이 잠깐 흔들려도 다음 clock edge 전에 가라앉으면 된다. clock 경로에서는 mux 출력 자체가 FF들의 clock이라 흔들림이 곧 clock edge가 된다. 게다가 sel은 보통 두 clock 어느 쪽과도 동기가 아니어서 clk0이 High인 도중에도 바뀔 수 있다. 아래 파형은 뒤에 나오는 testbench를 돌린 결과에서 60~84 ns 구간을 옮긴 것이다. clk0의 주기는 10 ns, clk1의 주기는 16 ns다.
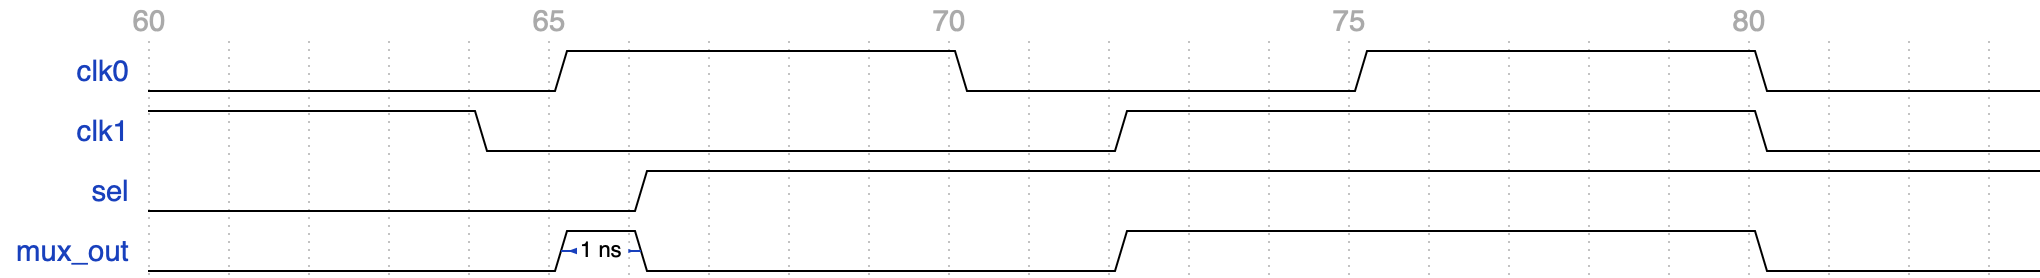
66 ns에 sel이 1이 되는 순간 clk0은 High, clk1은 Low다. mux_out은 65 ns에 clk0을 따라 올라갔다가 66 ns에 clk1의 Low로 떨어져 폭 1 ns짜리 pulse를 낸다. clk0의 원래 High 폭은 5 ns다. 이어서 72 ns에 clk1이 올라가면 mux_out에 곧바로 다음 rising edge가 생긴다.
이 pulse가 FF에 주는 피해는 두 가지다. 첫째, FF에는 clock pulse 폭의 최솟값(minimum pulse width)이 정해져 있어서 이보다 좁은 pulse에서는 capture가 되는지조차 보장할 수 없다. 둘째, 65 ns와 72 ns의 두 rising edge 사이는 7 ns로 clk0의 10 ns, clk1의 16 ns보다 짧다. 앞 절의 setup 식에 T_clk = 7을 넣는 셈이라, 이 clock을 쓰는 경로 가운데 7 ns 안에 끝나지 않는 것은 모두 setup 위반이 된다. 느린 clock으로 바꾸려다 한 주기 동안은 오히려 더 빠른 clock을 만든 것이다. sel이 바뀌는 순간 두 clock의 level에 따라 pulse가 잘리기도 하고, 늘어나기도 하고, edge가 하나 더 생기기도 한다.
옛 clock을 끊고 나서 새 clock을 잇는다
glitch-free clock mux는 지금 나가는 clock을 먼저 끊고, 끊긴 것을 확인한 뒤에 새 clock을 잇는다. 이 구조는 2003년 Rafey Mahmud가 EEdesign에 쓴 글에 정리돼 있고, 아래 구조도와 RTL은 그 글의 비동기 clock용 회로를 따랐다.
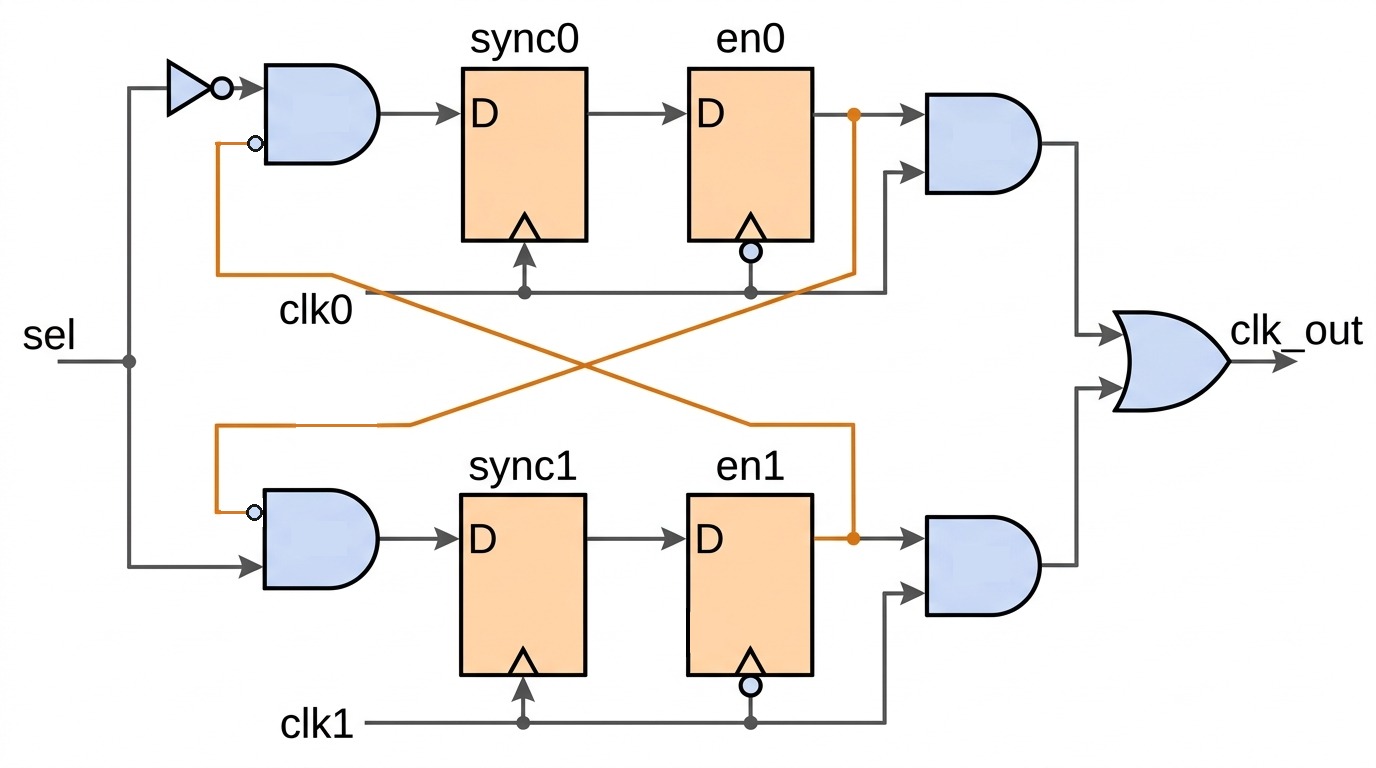
clock마다 가지(branch)가 하나씩 있다. 가지마다 FF 두 개와 AND gate 하나가 있고, 두 가지의 AND 출력을 OR로 합쳐 clk_out을 만든다. 첫 FF(sync)는 그 가지 clock의 rising edge에서, 둘째 FF(en)는 falling edge에서 동작한다. 각 가지의 첫 FF 입력에는 sel과 함께 반대편 가지의 enable이 반전돼 들어간다.
구조의 핵심은 세 가지다. 첫째, 반대편 enable을 feedback으로 받는다. clk1 가지는 en0이 0이 된 뒤에야 켜질 수 있으므로 두 clock이 동시에 출력으로 나가는 순간이 없다(break-before-make). 둘째, enable은 falling edge에서만 바뀐다. 그 clock이 Low인 동안 AND gate의 enable이 바뀌니 High pulse가 도중에 잘리거나 중간에서 시작하지 않는다. 가지마다 붙은 AND gate가 하는 일은 결국 clock gating이고, ICG 글에서 본 원리와 같다. 셋째, sel과 반대편 enable은 이 가지의 clock과 비동기라서, 먼저 rising edge FF로 받아 metastability가 가라앉을 시간을 준 뒤 falling edge FF로 넘긴다. 두 clock이 서로 정수배인 관계라면 Mahmud의 글처럼 falling edge FF 하나로 줄일 수 있다.
RTL로 옮기면 이렇다
아래는 이 구조를 그대로 옮긴 RTL이다. 같은 회로를 Verilog와 SystemVerilog로 한 번씩 썼다. 실제 칩에서는 가지의 AND gate 자리에 라이브러리의 ICG 같은 clock 전용 셀을 쓰는 편이 안전하다. ICG 글에서 본 대로 툴이 clock 경로의 셀로 알아보고, 셀 내부 timing이 검증돼 있기 때문이다.
`timescale 1ns/1ns
module glitch_free_mux (
    input  wire clk0,
    input  wire clk1,
    input  wire rst_n,
    input  wire sel,       // 0: clk0, 1: clk1 (asynchronous to both clocks)
    output wire clk_out
);
    reg sync0, en0;        // clk0 branch
    reg sync1, en1;        // clk1 branch

    // clk0 branch: ask for clk0 only after the clk1 branch has turned off
    always @(posedge clk0 or negedge rst_n)
        if (!rst_n) sync0 <= 1'b0;
        else        sync0 <= ~sel & ~en1;

    // enable changes on the falling edge, while clk0 is low
    always @(negedge clk0 or negedge rst_n)
        if (!rst_n) en0 <= 1'b0;
        else        en0 <= sync0;

    // clk1 branch: the same, with sel and the feedback swapped
    always @(posedge clk1 or negedge rst_n)
        if (!rst_n) sync1 <= 1'b0;
        else        sync1 <= sel & ~en0;

    always @(negedge clk1 or negedge rst_n)
        if (!rst_n) en1 <= 1'b0;
        else        en1 <= sync1;

    assign clk_out = (clk0 & en0) | (clk1 & en1);
endmodule`timescale 1ns/1ns
module glitch_free_mux (
input logic clk0,
input logic clk1,
input logic rst_n,
input logic sel, // 0: clk0, 1: clk1 (asynchronous to both clocks)
output logic clk_out
);
logic sync0, en0; // clk0 branch
logic sync1, en1; // clk1 branch
// clk0 branch: ask for clk0 only after the clk1 branch has turned off
always_ff @(posedge clk0 or negedge rst_n)
if (!rst_n) sync0 <= 1'b0;
else sync0 <= ~sel & ~en1;
// enable changes on the falling edge, while clk0 is low
always_ff @(negedge clk0 or negedge rst_n)
if (!rst_n) en0 <= 1'b0;
else en0 <= sync0;
// clk1 branch: the same, with sel and the feedback swapped
always_ff @(posedge clk1 or negedge rst_n)
if (!rst_n) sync1 <= 1'b0;
else sync1 <= sel & ~en0;
always_ff @(negedge clk1 or negedge rst_n)
if (!rst_n) en1 <= 1'b0;
else en1 <= sync1;
assign clk_out = (clk0 & en0) | (clk1 & en1);
endmodulesync0과 sync1이 rising edge FF, en0과 en1이 falling edge FF다. clk0 가지의 sync0은 sel이 0이고 en1이 0일 때만 1이 된다. clk1 가지는 sel과 feedback의 극성이 바뀌었을 뿐 같은 모양이다. reset 직후에는 두 enable이 모두 0이라 clk_out도 0이고, sel이 가리키는 가지가 rising edge와 falling edge를 하나씩 거쳐 켜지면 그때부터 clock이 나간다(SystemVerilog 쪽은 wire와 reg 대신 logic을, always 대신 always_ff를 쓴다). Verilator 5.052의 –lint-only -Wall로 두 코드를 검사하면 경고가 없다.
plain mux와 나란히 돌려 보면
아래 testbench는 같은 clk0, clk1, sel로 plain mux와 glitch-free mux를 함께 구동한다. sel은 66 ns에 1이 되고, 60 ns부터 120 ns 사이에 시작한 pulse를 두 출력마다 모두 기록했다가 끝에 출력한다. 뒤쪽의 clk1을 멈추는 시나리오는 다음 절에서 설명한다.
`timescale 1ns/1ns
module tb_clk_mux;
    logic clk0 = 0, clk1 = 0, run1 = 1;
    logic rst_n = 1, sel = 0;
    wire  mux_out, clk_out;

    always #5 clk0 = ~clk0;               // 100 MHz
    always #8 if (run1) clk1 = ~clk1;     // 62.5 MHz, stops while run1 is 0

    assign mux_out = sel ? clk1 : clk0;   // plain combinational mux
    glitch_free_mux u_mux (.clk0(clk0), .clk1(clk1), .rst_n(rst_n),
                           .sel(sel), .clk_out(clk_out));

    // pulses that start in 60..119 ns, and pulses counted after 162 ns
    time s[2][8], e[2][8];
    int  n[2] = '{0, 0}, late[2] = '{0, 0};
    time r[2];

    function automatic void log_pulse(int k, time t0, time t1);
        if (t0 >= 60 && t0 < 120 && n[k] < 8) begin
            s[k][n[k]] = t0; e[k][n[k]] = t1; n[k]++;
        end
        if (t0 >= 162) late[k]++;
    endfunction

    always @(posedge mux_out) r[0] = $time;
    always @(negedge mux_out) log_pulse(0, r[0], $time);
    always @(posedge clk_out) r[1] = $time;
    always @(negedge clk_out) log_pulse(1, r[1], $time);

    initial begin
        #1  rst_n = 0;
        #2  rst_n = 1;
        #63 sel = 1;       // 66 ns: clk0 is high, clk1 is low
        #84 run1 = 0;      // 150 ns: clk1 stops low
        #12 sel = 0;       // 162 ns: try to go back to clk0
        #86;               // 248 ns
        for (int i = 0; i < n[0]; i++)
            $display("plain mux  : pulse %0t-%0t ns, width %0t ns", s[0][i], e[0][i], e[0][i] - s[0][i]);
        for (int i = 0; i < n[1]; i++)
            $display("glitch-free: pulse %0t-%0t ns, width %0t ns", s[1][i], e[1][i], e[1][i] - s[1][i]);
        $display("clk1 stopped, sel=0 at 162 ns -> pulses after: plain mux %0d, glitch-free %0d", late[0], late[1]);
        $finish;
    end
endmodule
두 파일을 내가 만들고 있는 오픈소스 RTL 시뮬레이터 vitamin의 vita로 돌렸다. vita는 파일 이름만 넘기면 compile부터 simulation까지 한 번에 한다(만든 과정은 vitamin 연재에 적었다).
$ vita glitch_free_mux.sv tb_clk_mux.sv
plain mux  : pulse 65-66 ns, width 1 ns
plain mux  : pulse 72-80 ns, width 8 ns
plain mux  : pulse 88-96 ns, width 8 ns
plain mux  : pulse 104-112 ns, width 8 ns
glitch-free: pulse 65-70 ns, width 5 ns
glitch-free: pulse 75-80 ns, width 5 ns
glitch-free: pulse 104-112 ns, width 8 ns
clk1 stopped, sel=0 at 162 ns -> pulses after: plain mux 8, glitch-free 0
simulation ended (Finish) at time 248
errors=0 warnings=0 notes=0
plain mux는 앞의 파형대로 65 ns에 1 ns짜리 pulse를 내고, 72 ns부터 clk1을 그대로 내보낸다. glitch-free mux는 65~70 ns와 75~80 ns에 clk0의 pulse를 온전히 내보낸 뒤 80 ns부터 104 ns까지 clock을 내지 않고, 104 ns부터 clk1의 온전한 pulse를 낸다. iverilog로 돌리려면 아래 명령을 쓰면 되고, 같은 여덟 줄이 나온다. Verilator 5.052의 –binary –timing으로 돌려도 결과는 같다.
$ iverilog -g2012 -o sim glitch_free_mux.sv tb_clk_mux.sv && vvp sim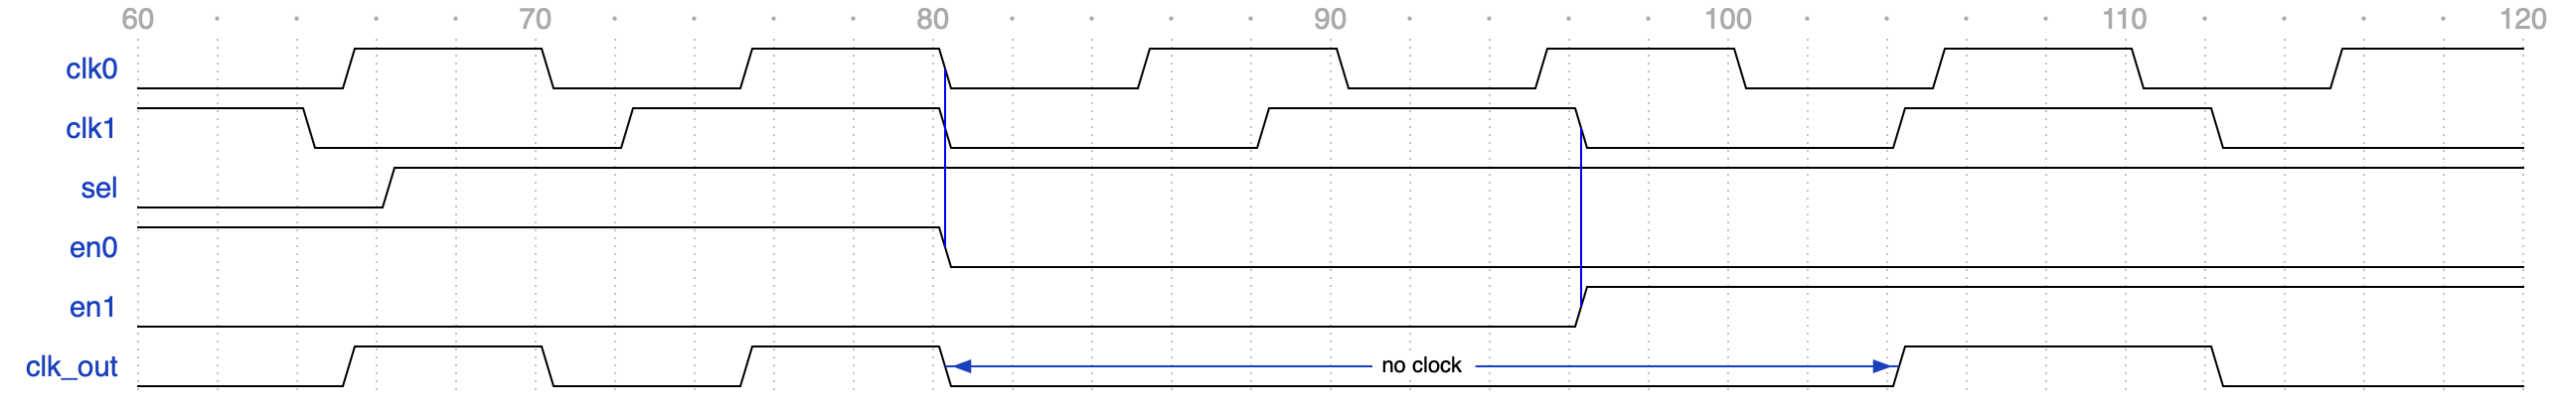
sel이 66 ns에 1이 되면 clk0 가지의 sync0이 75 ns rising edge에서 0이 되고, en0은 80 ns falling edge에서 0이 된다. clk0이 Low로 내려가는 순간 enable이 꺼지므로 75 ns에 시작한 pulse는 끝까지 나간다. en0이 0이 된 뒤 clk1 가지의 sync1이 88 ns rising edge에서 1이 되고, en1은 96 ns falling edge에서 1이 된다. clk1이 Low인 동안 켜졌으므로 clk_out에는 104 ns의 다음 rising edge부터 온전한 pulse가 나간다. 80 ns부터 104 ns까지 clock이 없는 구간이 break-before-make의 대가다. 전환에는 옛 clock의 edge 두 개와 새 clock의 edge 두 개가 필요하고, 이 예에서는 sel이 바뀐 뒤 첫 clk1 pulse까지 38 ns가 걸렸다.
두 clock이 모두 돌고 있어야 전환된다
testbench 출력의 마지막 줄은 이 구조의 약점을 보여 준다. 150 ns에 clk1을 Low에서 멈추고, 162 ns에 sel을 0으로 돌려 살아 있는 clk0으로 돌아가려 했다. plain mux는 바로 clk0을 내보내 248 ns까지 pulse 8개를 냈지만, glitch-free mux는 하나도 내지 못했다. en1을 끄려면 clk1의 rising edge와 falling edge가 있어야 하는데 clk1이 멈췄으니 en1은 1에 머물고, en1이 1인 동안 clk0 가지는 켜지지 않는다. 지금 쓰는 clock이 멈추면 다른 clock으로 넘어가지 못하는 것이다.
FPGA의 clock buffer도 같은 제약을 문서에 적어 둔다. Xilinx 7 series의 BUFGCTRL은 select가 바뀐 뒤 지금 clock이 High에서 Low로 내려가면 출력을 Low로 붙잡아 두고, 새 clock이 High에서 Low로 내려간 다음에야 새 clock을 내보낸다. 위 RTL과 같은 순서다. UG472는 입력 clock 하나가 멈추면 BUFGCTRL이 clock edge를 보지 못해 전환 조건이 채워지지 않는다고 설명하고, 이때는 IGNORE 핀을 1로 두어 select가 바뀌는 즉시 넘어가는 비동기 mux로 쓰라고 한다. 대신 IGNORE를 켜면 glitch 보호도 꺼진다.
그래서 clock source가 멈출 수 있는 설계라면, 예를 들어 외부 crystal이 떨어지는 상황까지 견뎌야 한다면, 멈춘 clock을 감지하는 회로를 따로 두고 감지되면 glitch 보호를 포기하더라도 강제로 넘어가는 경로를 만든다. 두 clock이 계속 돈다고 보장할 수 있으면 위 구조로 충분하다. 어느 쪽이든 PLL을 끄기 전에 먼저 다른 clock으로 옮겨 두는 순서는 software와 맞춰 둬야 한다. 쓰고 있는 clock을 먼저 끄면 mux가 그 clock에서 빠져나오지 못한다.
STA에는 두 clock이 함께 나가지 않는다고 알려 준다
mux 출력에는 clk0과 clk1이 번갈아 나가지만, STA 툴은 따로 알려 주지 않으면 두 clock이 동시에 그 선을 지나는 것으로 보고 둘 사이의 경로까지 검사한다. 그래서 mux 출력에 입력 clock마다 generated clock을 하나씩 정의하고, 두 clock이 함께 존재하지 않는다고 선언한다. Intel Quartus Timing Analyzer 문서의 clock multiplexer 예시를 이 글의 이름으로 옮기면 다음과 같다.
create_clock -name clk0 -period 10 [get_ports clk0]
create_clock -name clk1 -period 16 [get_ports clk1]
create_generated_clock -name clk0_mux -source [get_ports clk0] \
    [get_pins u_mux|clk_out]
create_generated_clock -name clk1_mux -source [get_ports clk1] \
    [get_pins u_mux|clk_out] -add
set_clock_groups -logically_exclusive -group clk0_mux -group clk1_mux
이 예시는 -logically_exclusive를 쓰는데, 두 clock이 같은 선에 물리적으로 함께 있을 수 없다는 뜻으로 -physically_exclusive를 쓰는 곳도 있다. 쓰는 STA 툴의 문서를 따르면 된다. 가지마다 있는 AND gate에는 clock gating check도 걸린다. clock이 High인 동안 enable이 바뀌지 않는지를 보는 검사다. 위 구조는 enable을 falling edge에서 바꾸므로 이 검사를 통과하도록 짜여 있지만, falling edge FF에서 AND gate까지의 delay가 Low 구간 안에 끝나는지는 STA로 확인해야 한다.
정리하면 clock을 늦추는 일은 setup 문제만 풀어 준다. hold는 같은 edge 안에서 벌어지는 경주라서 주파수와 상관없이 tape-out 전에 닫아야 한다. 그리고 clock을 바꾸는 순간 plain mux는 짧은 pulse를 만들어 한 주기 동안 오히려 빠른 clock을 내보낼 수 있다. glitch-free clock mux는 enable을 falling edge에서만 바꾸고, 옛 clock이 끊긴 것을 확인한 뒤 새 clock을 이어 이 문제를 막는다. 그 대가로 전환에 두 clock의 edge가 몇 개씩 필요하고, 쓰던 clock이 멈추면 넘어가지 못한다.
참고 자료
- vitamin, open-source RTL simulator (vita)
- Rafey Mahmud, Techniques to make clock switching glitch free (EEdesign, 2003)
- AMD Xilinx, 7 Series FPGAs Clocking Resources User Guide (UG472), BUFGCTRL
- Intel, Quartus Prime Pro Edition User Guide: Timing Analyzer, Clock Multiplexer Example
- Cadence, Innovus Implementation System datasheet (clock concurrent optimization)
- AMD, Vivado Design Suite User Guide: Implementation (UG904), Using the AXI Register Slice
- Neil Weste, David Harris, CMOS VLSI Design 4th ed., Ch. 10 Sequential Circuit Design