
서로 다른 clock으로 도는 두 영역 사이로 신호를 넘기는 CDC에서 무엇이 깨지는지와 synchronizer, handshake, async FIFO로 막는 방법을 정리한다. FIFO pointer에 쓰는 gray code의 규칙도 함께 본다.
SoC 안에서는 CPU, bus, DDR controller, 주변장치, 외부 interface가 저마다 다른 clock으로 돈다. 같은 clock을 받는 FF들의 묶음을 clock domain이라 하고, 한 domain의 FF에서 나온 신호를 다른 domain의 FF가 받는 경로를 CDC(clock domain crossing)라고 부른다. 두 clock이 한 source에서 정수비로 나와 edge 관계가 정해져 있으면 STA가 그 경로의 setup과 hold를 계산할 수 있다. 서로 무관한 비동기 clock이면 받는 FF에 데이터가 언제 도착할지 정해져 있지 않아서, setup과 hold를 보장할 방법 자체가 없다. setup, hold와 STA는 clock mux 글에서 다뤘다.
setup과 hold를 지킬 수 없으면 metastability가 생긴다
FF 안의 latch는 inverter 두 개가 서로의 출력을 붙잡는 구조다. D가 clock edge에 너무 가깝게 바뀌면 두 node가 0과 1의 중간에서 균형을 이룬 채 한동안 머무를 수 있는데, 이것이 metastability다. 균형점에서 빠져나오는 데 걸리는 시간은 정해져 있지 않고, 오래 머무를 확률이 시간에 따라 지수적으로 줄어들 뿐이다. Cummings는 multi-clock 설계에서 metastability 자체는 피할 수 없고 그 영향만 막을 수 있다고 정리한다.

d가 clk edge 바로 앞에서 바뀌어 첫 FF의 출력 q1이 metastable에 빠진 경우다. q1은 빗금 구간 동안 0도 1도 아닌 상태에 있다가 1로 정해지고, 둘째 FF의 q2는 다음 edge에서 이미 정해진 q1을 받는다. S는 q1이 정해질 때까지 쓸 수 있는 시간으로, 대략 받는 clock의 한 주기다.
metastable한 출력이 그대로 logic으로 퍼지면 문제가 커진다. 같은 선을 받는 gate들이 중간 전압을 서로 다르게 읽으면, 어떤 곳은 1로, 어떤 곳은 0으로 동작해 설계가 있을 수 없는 상태로 들어간다. 그래서 비동기 입력은 첫 FF가 정해질 시간을 벌어 준 뒤에야 logic에 넘긴다.
MTBF로 실패가 얼마나 드문지 계산한다
metastability를 없앨 수는 없으니, 실패가 얼마나 드문지를 계산해 충분히 드물게 만든다. Ginosar의 튜토리얼(IEEE Design & Test, 2011)은 synchronizer의 평균 실패 간격(MTBF, mean time between failures)을 다음과 같이 정리한다.
MTBF = e^(S / tau) / (T_W x F_C x F_D)T_W는 데이터가 그 안에서 바뀌면 metastable에 빠질 수 있는 edge 주변의 짧은 구간, F_C는 받는 clock의 주파수, F_D는 데이터가 바뀌는 빈도다. 분모는 1초에 metastable에 빠지는 횟수다. tau는 균형점에서 빠져나오는 속도를 나타내는 시상수로 공정의 gate delay 수준이고, S는 해소에 쓸 수 있는 시간이다. S가 지수에 들어 있어서 S를 조금만 늘려도 MTBF는 크게 늘어난다.
Ginosar는 28 nm 공정을 가정해 tau = 10 ps, T_W = 20 ps, F_C = 1 GHz, 데이터가 10주기에 한 번 바뀌고 S가 한 주기일 때 MTBF가 4 x 10^29년이라고 계산했다. 반대로 낮은 전압과 높은 온도 때문에 tau = 100 ps, T_W = 200 ps가 되면, F_D를 1 kHz로 낮게 잡아도 FF 두 개로는 MTBF가 1분 정도로 떨어진다. 같은 조건에서 FF를 세 개로 늘리면 한 달 정도, 네 개면 1,000년 정도가 된다. MTBF는 synchronizer 개수에 거의 반비례하므로, synchronizer가 1,000개인 칩이라면 각각을 목표보다 1,000배 이상 길게 설계해야 한다.
S는 한 주기를 온전히 쓰지 못한다. 첫 FF의 clock-to-Q delay, 둘째 FF의 setup time, 둘 사이 배선의 delay를 뺀 나머지가 S다. 두 FF 사이에 logic을 넣지 않고 두 FF를 가까이 배치하는 이유다. Ginosar는 이 배치를 놓쳐 실패한 synchronizer가 적지 않다고 적는다.
2-FF synchronizer와 3단이 필요한 경우
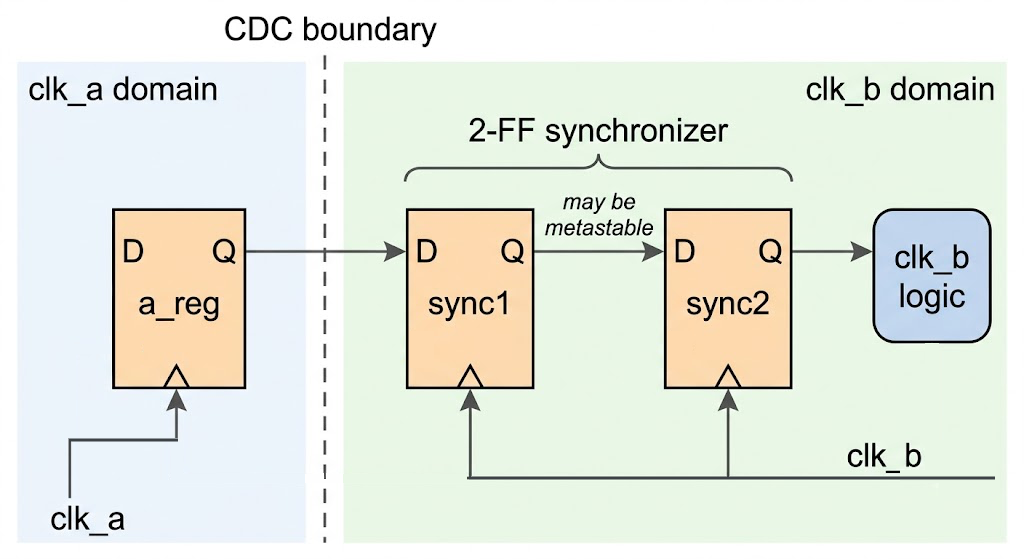
가장 흔한 synchronizer는 받는 쪽 clock으로 도는 FF 두 개를 직렬로 이은 것이다. 첫 FF(sync1)는 비동기 신호를 받아 metastable에 빠질 수 있고, 둘째 FF(sync2)는 한 주기 뒤에 이미 정해진 값을 받아 받는 쪽 logic에 넘긴다.
`timescale 1ns/1ns
module sync_2ff (
    input  logic clk,      // destination clock
    input  logic rst_n,
    input  logic d,        // from another clock domain, registered at the source
    output logic q
);
    logic meta;            // first stage: may go metastable

    always_ff @(posedge clk or negedge rst_n)
        if (!rst_n) {q, meta} <= 2'b00;
        else        {q, meta} <= {meta, d};
endmodule
첫 FF가 metastable에 빠졌다가 어느 쪽으로 정해지느냐에 따라 q는 입력이 바뀐 뒤 한 주기 또는 두 주기 뒤에 바뀐다. Ginosar의 표현대로 synchronizer는 전압이 정해지지 않는 아날로그 불확실성을, 한 주기 늦느냐 마느냐의 디지털 불확실성으로 바꿔 준다. 이 한 주기 차이가 뒤에서 볼 multi-bit 문제의 원인이 된다.
clock이 1 GHz를 넘거나, 전압이 매우 낮거나, 온도가 극단적인 조건에서는 2단으로 MTBF가 모자랄 수 있고 이때 3단을 쓴다. 몇 단이면 충분한지는 위 식으로 계산해 설계자가 정한다. ASIC에서는 라이브러리가 characterization을 마친 synchronizer 전용 셀을 주기도 하고, AMD FPGA에서는 synchronizer FF에 ASYNC_REG 속성을 붙여 두 FF를 같은 slice에 가까이 배치하게 한다.
보내는 쪽 신호는 반드시 FF에서 바로 나와야 한다. combinational logic을 거친 신호는 값이 정해지기 전에 glitch를 여러 번 낼 수 있고, 받는 쪽은 그 glitch 하나를 진짜 pulse로 잡을 수 있다. glitch는 데이터가 바뀌는 빈도(F_D)를 높이는 효과도 있어서 MTBF도 줄어든다.
pulse는 사라지고, 여러 비트는 서로 다른 주기에 도착한다
빠른 clock에서 한 주기짜리 pulse를 느린 clock으로 넘기면, pulse가 느린 clock의 두 edge 사이에 끼어 아예 잡히지 않을 수 있다. 받는 clock 한 주기보다 조금 긴 pulse도 안전하지 않다. 앞 edge에서는 setup을, 뒤 edge에서는 hold를 어기면 역시 놓친다. Cummings가 인용한 Litterick의 규칙은 입력이 받는 clock edge 세 개 동안 유지돼야 한다는 것으로, 받는 clock 주기의 1.5배 이상이다.
여러 비트를 비트마다 synchronizer에 넣는 것도 위험하다. 비트마다 첫 FF가 metastable에서 빠져나오는 방향이 다르면 어떤 비트는 한 주기 뒤에, 어떤 비트는 두 주기 뒤에 도착한다. 배선 길이와 rise, fall time 차이 때문에 같은 edge에서 출발한 비트들이 받는 쪽 edge 앞뒤로 갈리기도 한다. 4-bit binary counter가 0111에서 1000으로 바뀌는 순간을 잡으면, 0000부터 1111까지 어느 값이든 나올 수 있다.
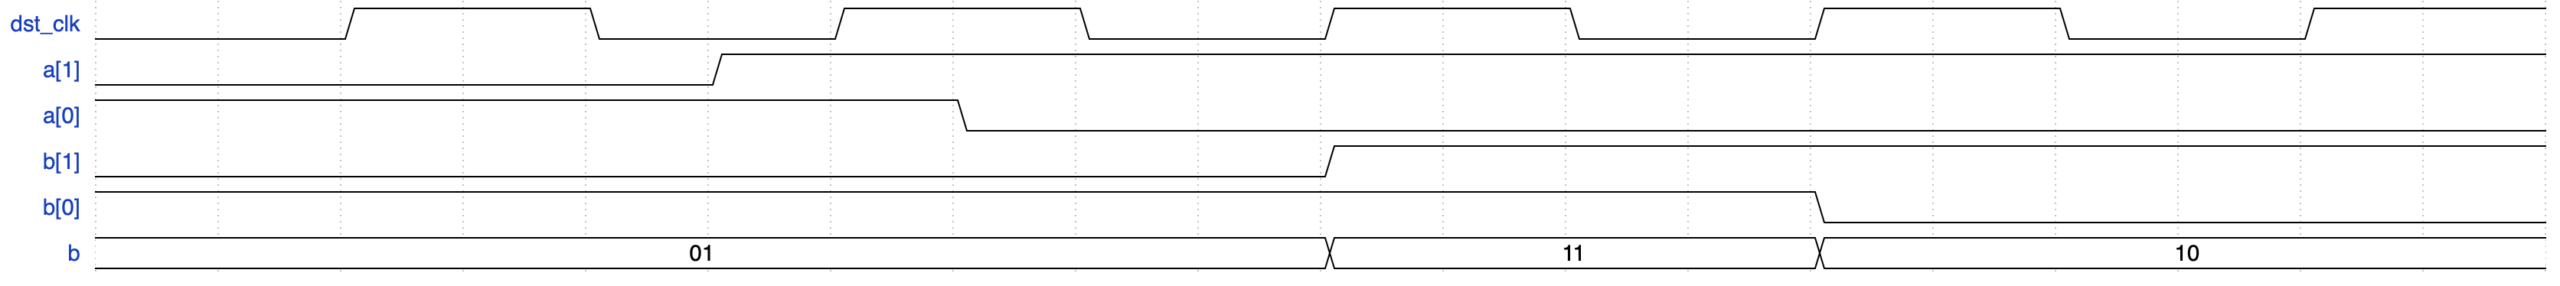
보내는 쪽 a가 01에서 10으로 바뀌었는데 a[0]이 조금 늦게 도착해 받는 쪽 edge를 하나 놓친 경우다. 2-FF synchronizer를 지난 b는 한 주기 동안 11이 되는데, 이 값은 보내는 쪽에 한 번도 존재한 적이 없다.
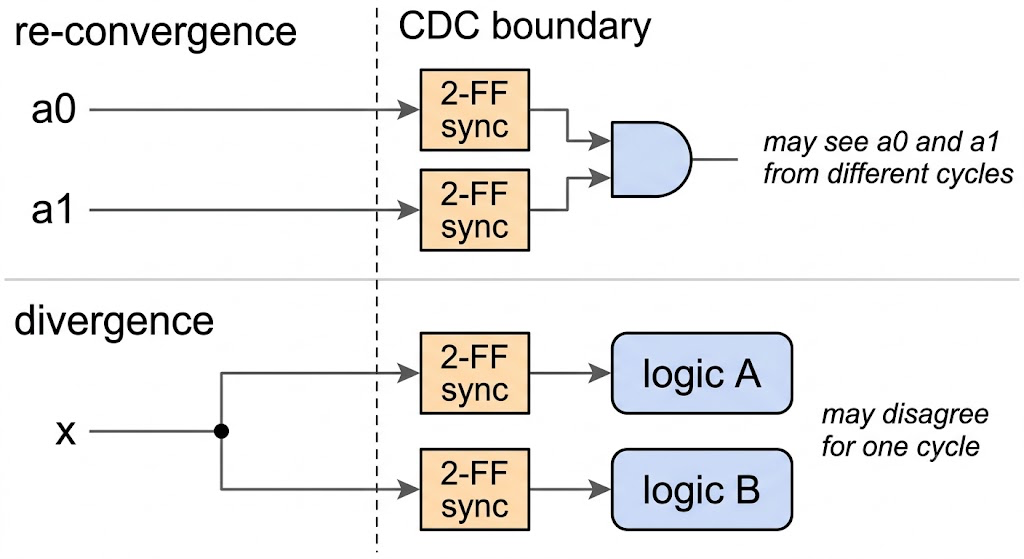
따로 동기화한 신호들을 받는 쪽에서 다시 합치는 구조를 re-convergence라고 부른다. AND gate, mux select, decoder, FSM의 다음 상태 logic처럼 두 신호를 함께 보는 곳이면 어디서나 생긴다. Cummings의 예로는 register에 load와 enable을 따로 넘겼다가 두 신호가 서로 다른 주기에 도착해 값이 실리지 않는 경우, 두 비트로 encode한 제어 신호가 한 주기 동안 엉뚱한 값으로 decode되는 경우가 있다. 반대로 한 신호를 synchronizer 두 개로 따로 받는 divergence도 금지된다. Ginosar는 한쪽은 1로, 다른 쪽은 0으로 정해져 설계가 모순된 상태에 빠질 수 있다고 경고한다. 예외는 gray code처럼 한 번에 한 비트만 바뀌도록 보장된 신호다.
데이터와 제어 신호 사이의 경주도 있다. 뒤에서 볼 MCP formulation과 handshake는 데이터 bus를 동기화하지 않고 넘기되, 제어 신호가 동기화돼 도착할 때쯤엔 데이터가 이미 안정돼 있다고 가정한다. 데이터 경로의 delay가 제어 신호의 동기화 지연보다 길면 받는 쪽은 바뀌는 중인 데이터를 잡는다. 보내는 쪽이 ack를 받기 전에 데이터를 바꿔도 마찬가지다. 그래서 비동기 경로라도 데이터 경로의 delay에는 상한을 둬야 한다. 이 제약은 마지막 절에서 다시 본다.
1비트 신호는 level이면 2-FF로, pulse면 toggle로 바꿔서 넘긴다
enable이나 상태 flag처럼 한번 바뀌면 오래 유지되는 level 신호는 2-FF synchronizer로 충분하다. 문제는 pulse다. 방법은 두 가지다. 받는 clock과의 주파수 관계가 고정돼 있으면 pulse를 edge 세 개 이상으로 늘려 보내는 open-loop 방식을 쓸 수 있다. Cummings는 이 조건이 깨지는지 SystemVerilog assertion으로 감시하라고 권한다. 주파수 관계가 바뀔 수 있으면 받는 쪽이 ack를 돌려보내는 closed-loop 방식을 쓴다.
자주 쓰는 또 하나의 방법은 pulse를 level의 변화로 바꿔 넘기는 toggle synchronizer다. 보내는 쪽은 pulse가 올 때마다 FF 하나를 뒤집고, 받는 쪽은 그 level을 2-FF로 동기화한 뒤 직전 값과 XOR해 변화가 있을 때 한 주기짜리 pulse를 만든다. level은 다음 pulse가 올 때까지 유지되므로 느린 쪽이 반드시 잡는다. 대신 pulse 두 개가 받는 쪽 한두 주기 안에 연달아 오면 level이 두 번 뒤집혀 변화가 사라지므로, pulse 사이 간격을 받는 쪽 몇 주기 이상으로 보장해야 한다.
`timescale 1ns/1ns
module pulse_sync (
    input  logic src_clk,
    input  logic src_rst_n,
    input  logic src_pulse,     // one src_clk cycle wide
    input  logic dst_clk,
    input  logic dst_rst_n,
    output logic dst_pulse      // one dst_clk cycle wide
);
    logic       src_tgl;        // flips once per source pulse
    logic [2:0] dst_sync;       // [1:0]: 2-FF synchronizer, [2]: previous value

    always_ff @(posedge src_clk or negedge src_rst_n)
        if (!src_rst_n)     src_tgl <= 1'b0;
        else if (src_pulse) src_tgl <= ~src_tgl;

    always_ff @(posedge dst_clk or negedge dst_rst_n)
        if (!dst_rst_n) dst_sync <= '0;
        else            dst_sync <= {dst_sync[1:0], src_tgl};

    // a change of the synchronized level becomes one dst_clk pulse
    assign dst_pulse = dst_sync[2] ^ dst_sync[1];
endmodule
아래 testbench는 주기 10 ns인 clock에서 한 주기짜리 pulse를 다섯 번 보내고, 주기 26 ns인 clock 쪽에서 받는다. 같은 pulse를 2-FF synchronizer에 그대로 넣은 경로와 toggle synchronizer를 지난 경로가 각각 pulse를 몇 개 잡는지 센다.
`timescale 1ns/1ns
module tb_pulse_sync;
    logic src_clk = 0, dst_clk = 0;
    logic rst_n = 1, src_pulse = 0;
    logic plain_q, plain_prev;          // raw pulse through a 2-FF synchronizer
    wire  tgl_pulse;                    // pulse through the toggle synchronizer
    int   plain_cnt = 0, tgl_cnt = 0;

    always #5  src_clk = ~src_clk;      // 10 ns period
    always #13 dst_clk = ~dst_clk;      // 26 ns period

    sync_2ff   u_plain (.clk(dst_clk), .rst_n(rst_n), .d(src_pulse), .q(plain_q));
    pulse_sync u_tgl   (.src_clk(src_clk), .src_rst_n(rst_n), .src_pulse(src_pulse),
                        .dst_clk(dst_clk), .dst_rst_n(rst_n), .dst_pulse(tgl_pulse));

    always_ff @(posedge dst_clk) plain_prev <= plain_q;
    always @(posedge dst_clk) begin
        if (plain_q && !plain_prev) plain_cnt++;   // rising edge of the plain path
        if (tgl_pulse)              tgl_cnt++;
    end

    initial begin
        #1 rst_n = 0;
        #2 rst_n = 1;
        repeat (5) begin
            repeat (11) @(posedge src_clk);
            src_pulse <= 1'b1;                  // one src_clk cycle wide
            @(posedge src_clk);
            src_pulse <= 1'b0;
        end
        repeat (12) @(posedge dst_clk);
        $display("sent 5 pulses: plain 2-FF saw %0d, toggle synchronizer saw %0d", plain_cnt, tgl_cnt);
        $finish;
    end
endmodule
이 파일들을 내가 만들고 있는 오픈소스 RTL 시뮬레이터 vitamin의 vita로 돌렸다. vita는 파일 이름만 넘기면 compile부터 simulation까지 한 번에 한다(만든 과정은 vitamin 연재에 적었다).
$ vita sync_2ff.sv pulse_sync.sv tb_pulse_sync.sv
sent 5 pulses: plain 2-FF saw 1, toggle synchronizer saw 5
simulation ended (Finish) at time 897
errors=0 warnings=0 notes=0
2-FF에 pulse를 그대로 넣은 경로는 다섯 개 중 한 개만 잡았다. 받는 쪽 rising edge가 우연히 10 ns짜리 pulse 안에 들어온 한 번뿐이다. toggle synchronizer는 다섯 개를 모두 잡았다. iverilog로는 아래 명령으로 돌리면 되고 결과가 같다. Verilator 5.052의 –binary –timing으로 돌려도 같다.
$ iverilog -g2012 -o sim sync_2ff.sv pulse_sync.sv tb_pulse_sync.sv && vvp sim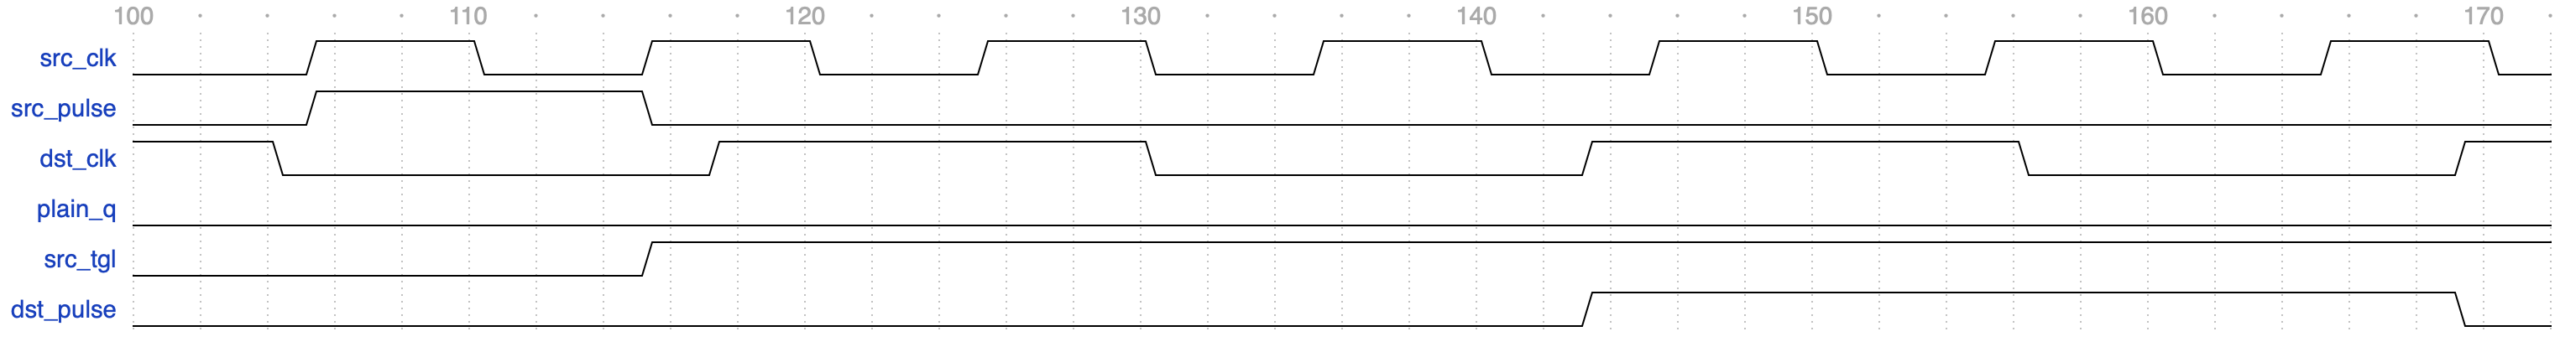
첫 pulse 부분을 simulation 결과 그대로 옮겼다. src_pulse는 105 ns부터 115 ns까지 High인데, dst_clk의 rising edge는 91 ns와 117 ns에 있어서 plain_q는 끝내 0이다. toggle 쪽은 115 ns에 src_tgl이 1로 바뀌어 그대로 머물고, dst_clk의 117 ns와 143 ns edge를 거쳐 143 ns부터 한 주기 동안 dst_pulse가 나온다.
handshake는 req와 ack를 주고받는다
closed-loop 방식의 기본형이 handshake다. 보내는 쪽이 req를 올리면 받는 쪽이 req를 동기화해 확인하고 ack를 올린다. ack가 다시 보내는 쪽으로 동기화돼 돌아온 뒤에야 보내는 쪽은 다음 동작을 한다. 데이터를 함께 보낼 때도 동기화하는 것은 req와 ack뿐이고, 데이터는 req를 올리기 전에 bus에 올려 두고 ack가 올 때까지 유지한다. Ginosar는 데이터를 비트마다 동기화하려는 시도가 대개 파국으로 끝난다고 쓴다.

위 두 줄은 4-phase handshake다. req가 오르면 ack가 오르고, req가 내려가면 ack가 내려가 한 번의 전송에 전이가 네 번 일어난다. 신호가 매번 0으로 돌아오므로 return-to-zero, 또는 level signaling이라고도 부른다. 아래 두 줄은 2-phase handshake로, req와 ack가 오르든 내리든 전이 하나가 사건 하나다. Sparsø의 비동기 회로 튜토리얼은 이를 non-return-to-zero 또는 transition signaling이라고 부르고, 0으로 돌아가는 전이를 없애 시간과 에너지를 아낀다고 설명한다. 앞의 toggle synchronizer가 바로 2-phase 방식이다. 대가는 지연이다. req를 받는 데 받는 쪽 두 주기, ack를 받는 데 보내는 쪽 두 주기가 들고, 4-phase라면 req와 ack를 내리는 데 그만큼이 한 번 더 든다.
여러 비트는 하나로 묶거나, 데이터를 붙잡아 두고 제어 신호만 동기화한다
Cummings는 multi-bit CDC 해법을 세 갈래로 나눈다. 여러 제어 신호를 1비트로 합치는 consolidation, 데이터를 동기화하지 않고 붙잡아 둔 채 load 신호만 동기화하는 MCP(multi-cycle path) formulation, 그리고 gray code다. 데이터가 계속 흘러가는 경로에는 FIFO를 쓴다.
consolidation은 가장 먼저 따져 볼 방법이다. load와 enable을 따로 보낼 필요 없이 load_enable 하나로 합치면 두 신호가 어긋날 일이 없다. 한 주기 차이를 두고 순서대로 나가야 하는 enable 두 개라면, 첫째만 넘기고 둘째는 받는 쪽에서 FF 하나로 한 주기 늦춰 만든다.
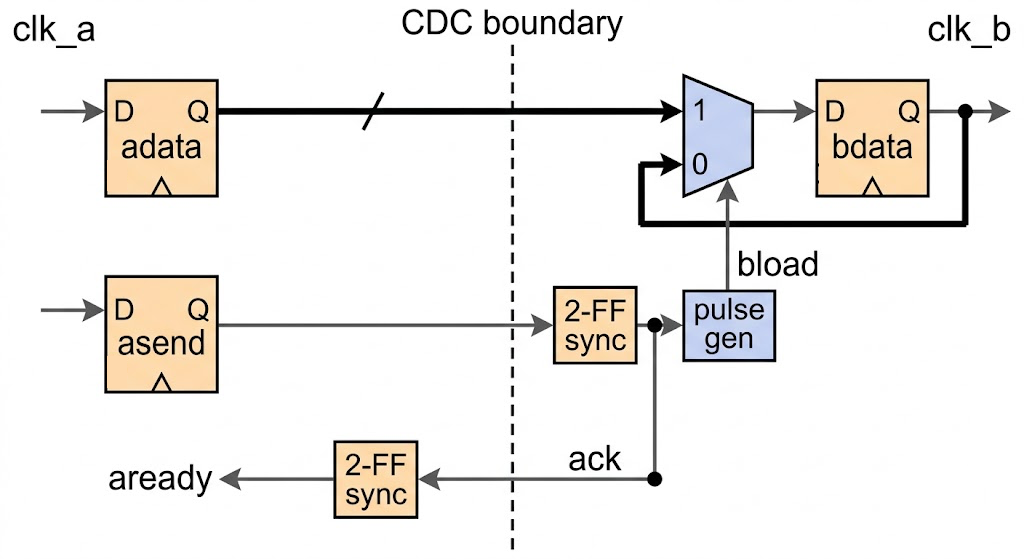
MCP formulation은 데이터 bus를 동기화 없이 넘기고, 데이터가 바뀌지 않는 여러 주기 동안 제어 신호만 동기화하는 방식이다. 보내는 쪽은 데이터를 adata register에 올린 뒤 toggle FF인 asend를 뒤집고, 받는 쪽은 asend를 앞의 toggle synchronizer와 같은 방식으로 받아(2-FF sync 뒤 XOR edge detect) 한 주기짜리 bload pulse를 만든다. bdata 앞의 mux는 평소엔 자기 출력을 되받아 값을 유지하다가(mux recirculation) bload가 온 주기에만 새 데이터를 싣는다. 데이터는 이미 몇 주기 전부터 안정돼 있으므로 bdata가 metastable이 될 일이 없다. ack로 돌려보내는 것은 한 주기짜리 bload가 아니라 동기화를 마친 toggle level이다. pulse를 그대로 돌려보내면 앞에서 본 것처럼 사라질 수 있기 때문이다. 이 level을 보내는 쪽 clock으로 다시 동기화해 asend와 같아지면 aready가 1이 되고, 보내는 쪽은 그때 다음 데이터를 올린다.
Cummings는 FF 두 개로 된 1-deep FIFO도 소개한다. 깊이가 2라서 pointer가 1비트 toggle FF이고, 쓰면 full이 되고 읽으면 empty가 되는 구조라 handshake와 비슷하게 동작하면서 데이터를 하나 쌓아 둘 수 있다. 데이터가 연속으로 흐르는 경로라면 async FIFO가 답이다.
async FIFO는 데이터가 아니라 pointer를 동기화한다
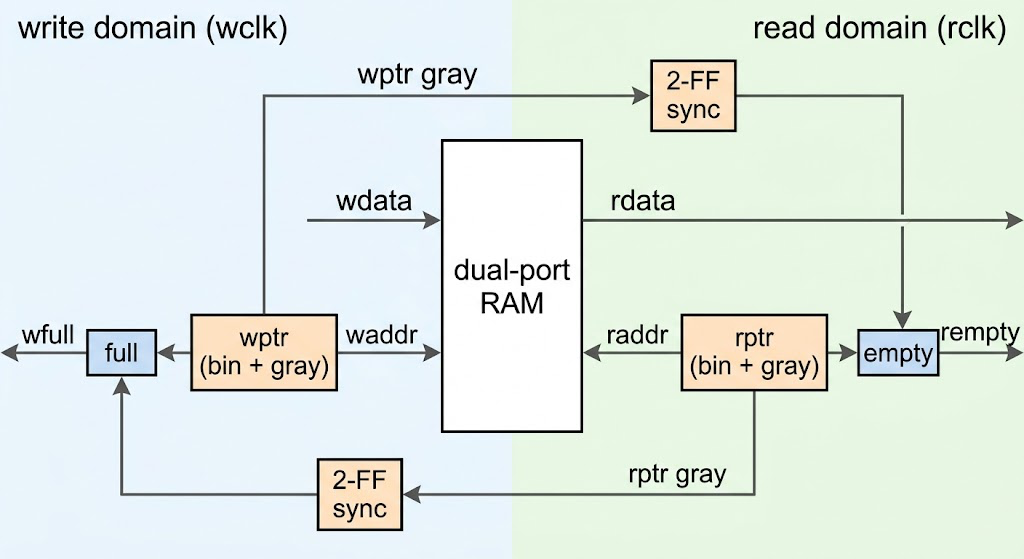
async FIFO는 dual-port RAM 하나를 두 domain이 나눠 쓴다. 쓰는 쪽은 write pointer가 가리키는 칸에 쓰고 pointer를 올리며, 읽는 쪽은 read pointer가 가리키는 칸을 읽고 pointer를 올린다. 데이터는 RAM에 쓴 뒤 몇 주기가 지나서야 읽히므로 동기화할 필요가 없다. 동기화하는 것은 full과 empty를 판정하려고 상대 domain으로 넘기는 pointer뿐이다. full은 쓰는 쪽 clock에서, empty는 읽는 쪽 clock에서 판정한다.
pointer는 주소보다 한 비트 넓게 만든다. 깊이가 16이면 주소는 4비트지만 pointer는 5비트다. 두 pointer가 모든 비트까지 같으면 읽는 쪽이 쓰는 쪽을 따라잡은 것이니 empty이고, 맨 위 비트만 다르고 나머지가 같으면 쓰는 쪽이 한 바퀴 더 돌아 따라잡은 것이니 full이다. 문제는 이 pointer를 상대 domain으로 넘기는 일이다. binary pointer는 0111에서 1000으로 갈 때처럼 여러 비트가 한꺼번에 바뀌어서 앞에서 본 multi-bit 문제가 그대로 생긴다. 그래서 pointer를 gray code로 바꿔 넘긴다. gray code는 한 번 셀 때 한 비트만 바뀌므로, 받는 쪽은 바뀌기 전 값이나 바뀐 뒤 값 둘 중 하나를 잡고, 둘 다 실제로 존재했던 값이다.
gray code pointer로 full을 판정할 때는 조건이 조금 달라진다. 아래는 Cummings(2002)의 방식을 따른 쓰는 쪽 pointer logic이다. binary counter를 올린 뒤 gray로 바꿔 register에 담고, 읽는 쪽 gray pointer를 2-FF synchronizer로 받아 비교한다.
`timescale 1ns/1ns
// write side of an async FIFO with 2**ASIZE entries
module wptr_full #(parameter int ASIZE = 4) (
    input  logic             wclk,
    input  logic             wrst_n,
    input  logic             winc,
    input  logic [ASIZE:0]   rptr,        // gray read pointer from the rclk domain
    output logic [ASIZE-1:0] waddr,
    output logic [ASIZE:0]   wptr,        // gray write pointer, sent to the rclk domain
    output logic             wfull
);
    logic [ASIZE:0] wbin, wbin_next, wgray_next;
    logic [ASIZE:0] rptr_meta, rptr_sync;  // 2-FF synchronizer on all bits

    assign wbin_next  = wbin + {{ASIZE{1'b0}}, winc & ~wfull};
    assign wgray_next = wbin_next ^ (wbin_next >> 1);
    assign waddr      = wbin[ASIZE-1:0];

    always_ff @(posedge wclk or negedge wrst_n)
        if (!wrst_n) {wbin, wptr} <= '0;
        else         {wbin, wptr} <= {wbin_next, wgray_next};

    always_ff @(posedge wclk or negedge wrst_n)
        if (!wrst_n) {rptr_sync, rptr_meta} <= '0;
        else         {rptr_sync, rptr_meta} <= {rptr_meta, rptr};

    // full: the two MSBs differ, all other bits are equal
    always_ff @(posedge wclk or negedge wrst_n)
        if (!wrst_n) wfull <= 1'b0;
        else         wfull <= (wgray_next == {~rptr_sync[ASIZE:ASIZE-1], rptr_sync[ASIZE-2:0]});
endmodule
full 조건은 맨 위 두 비트가 모두 반대이고 나머지가 같은 것이다. binary에서 맨 위 비트만 다른 두 값을 gray로 바꾸면, 뒤에서 볼 반사 구조 때문에 맨 위 두 비트가 함께 뒤집히기 때문이다. 깊이 16짜리 FIFO에서 read pointer가 0일 때 16번 쓰면 binary write pointer는 10000, gray는 11000이 되고 00000의 맨 위 두 비트를 뒤집은 값과 같아 full이 된다. 이 module에 16번 연속 쓰기를 넣어 보면 vita와 iverilog 모두 16번째 쓰기 뒤에 wfull이 1이 된다.
빠른 쪽 pointer가 느린 쪽 clock 한 주기 사이에 두 번 이상 올라가도 괜찮다. 앞선 변화는 edge에서 멀리 떨어져 있어 이미 안정돼 있고, edge 근처에서 바뀌는 비트는 마지막 한 비트뿐이다. 받는 쪽이 보는 상대 pointer는 조금 옛날 값이지만, 그 때문에 생기는 효과는 full과 empty가 실제보다 두어 주기 늦게 풀리는 것뿐이다. 켜지는 쪽은 제때 켜지므로 overflow나 underflow는 생기지 않는다. Cummings는 이를 pessimistic하다고 표현한다.
gray code의 표준은 reflected binary code다
gray code라는 이름은 Bell 연구소의 Frank Gray에서 왔다. 그가 1947년에 출원해 1953년에 등록된 미국 특허(US 2,632,058)는 이 코드를 reflected binary code라고 불렀다. 특허의 설명대로 이 코드는 일반 binary를 적은 뒤 그 아래에 가로축 기준으로 뒤집은 목록을 붙이는 반사로 만들어지고, 각 수의 부호는 바로 위와 아래 수의 부호와 한 자리만 다르다. 지금 설계에서 그냥 gray code라고 하면 이 binary reflected gray code를 가리킨다.
만드는 법은 간단하다. 1비트 목록 0, 1에서 시작해, 목록을 적고 그 아래에 거꾸로 뒤집어 붙인 뒤, 앞 절반 앞에는 0을, 뒤 절반 앞에는 1을 붙인다. 2비트는 00, 01, 11, 10이 되고, 같은 과정을 한 번 더 하면 3비트는 000, 001, 011, 010, 110, 111, 101, 100이다. 뒤 절반이 앞 절반의 거울상이므로 i번째 코드와 끝에서 i번째 코드는 맨 위 비트만 다르다. 마지막 코드와 첫 코드도 맨 위 비트만 달라서, 끝에서 처음으로 돌아갈 때도 한 비트만 바뀐다.
binary와 gray 사이의 변환은 XOR 몇 개면 된다. binary를 오른쪽으로 한 칸 민 값과 XOR하면 gray가 되고, 거꾸로 gray의 i번째부터 맨 위까지를 모두 XOR하면 binary의 i번째 비트가 된다. Cummings(2008)가 쓴 것과 같은 식이다.
`timescale 1ns/1ns
module bin2gray #(parameter int N = 4) (
    input  logic [N-1:0] bin,
    output logic [N-1:0] gray
);
    assign gray = bin ^ (bin >> 1);
endmodule`timescale 1ns/1ns
module gray2bin #(parameter int N = 4) (
input logic [N-1:0] gray,
output logic [N-1:0] bin
);
always_comb
for (int i = 0; i < N; i++)
bin[i] = ^(gray >> i); // XOR of gray[N-1:i]
endmodule아래 testbench는 0부터 15까지 세고 다시 0으로 돌아가면서 binary와 gray 값, 그리고 직전 값과 비교해 바뀐 비트 수를 출력한다.
`timescale 1ns/1ns
module tb_gray;
    logic [3:0] bin, gray, back, prev_bin, prev_gray, dbin, dgray;
    int errors = 0;

    bin2gray #(4) u_b2g (.bin(bin), .gray(gray));
    gray2bin #(4) u_g2b (.gray(gray), .bin(back));

    initial begin
        $display(" n  bin   gray  bits changed (bin, gray)");
        for (int n = 0; n <= 16; n++) begin
            bin = n[3:0];                       // 16 wraps back to 0
            #1;
            if (back != bin) errors++;
            dbin  = bin ^ prev_bin;             // bits that changed
            dgray = gray ^ prev_gray;
            if (n == 0) $display("%2d  %b  %b", n, bin, gray);
            else        $display("%2d  %b  %b  %0d, %0d", n % 16, bin, gray,
                                 $countones(dbin), $countones(dgray));
            prev_bin = bin;
            prev_gray = gray;
        end
        $display("gray2bin(bin2gray(n)) mismatches: %0d", errors);
        $finish;
    end
endmodule$ vita bin2gray.sv gray2bin.sv tb_gray.sv
n bin gray bits changed (bin, gray)
0 0000 0000
1 0001 0001 1, 1
2 0010 0011 2, 1
3 0011 0010 1, 1
4 0100 0110 3, 1
5 0101 0111 1, 1
6 0110 0101 2, 1
7 0111 0100 1, 1
8 1000 1100 4, 1
9 1001 1101 1, 1
10 1010 1111 2, 1
11 1011 1110 1, 1
12 1100 1010 3, 1
13 1101 1011 1, 1
14 1110 1001 2, 1
15 1111 1000 1, 1
0 0000 0000 4, 1
gray2bin(bin2gray(n)) mismatches: 0
simulation ended (Finish) at time 17
errors=0 warnings=0 notes=04비트 gray는 0000, 0001, 0011, 0010, 0110, 0111, 0101, 0100, 1100, 1101, 1111, 1110, 1010, 1011, 1001, 1000 순서로 바뀐다. binary는 한 번 셀 때 1~4비트가 바뀌지만 gray는 15에서 0으로 돌아갈 때까지 항상 한 비트만 바뀐다. 어느 비트가 바뀌는지에도 규칙이 있다. n번째로 셀 때는 n을 binary로 쓴 값의 맨 아래 1이 있는 자리의 비트가 바뀐다. 그래서 g[0]은 두 번에 한 번, g[1]은 네 번에 한 번, g[2]는 여덟 번에 한 번 바뀐다.
이 testbench를 처음 짤 때는 $countones(bin ^ prev_bin)처럼 XOR 식을 바로 넘겼다. vita와 Verilator는 1~4를 냈는데, iverilog 13.0은 4비트에서 나올 수 없는 6, 7, 8을 냈다. 따로 확인해 보니 iverilog 13.0은 $countones에 변수 하나를 넘기면 맞게 세지만 식을 넘기면 틀린 값을 냈다. 위 코드처럼 XOR 결과를 변수에 먼저 담으면 세 simulator의 출력이 같다.
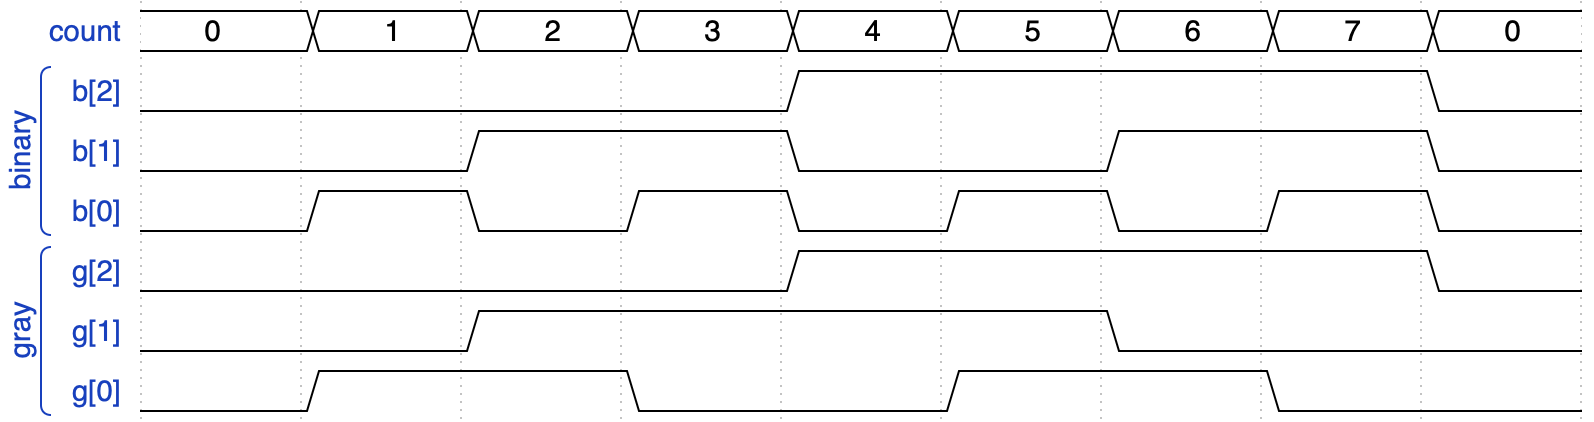
3비트 counter를 0부터 7까지 세고 다시 0으로 돌아간 모습이다. binary 쪽은 3에서 4로, 7에서 0으로 넘어갈 때 세 비트가 한꺼번에 바뀌지만, gray 쪽은 어느 순간이든 한 줄만 바뀐다.
gray code를 직접 정해서 써도 되는가
synchronizer 입장에서 필요한 조건은 하나다. 이웃한 두 값이, 끝에서 처음으로 돌아가는 경우까지 포함해 항상 한 비트만 달라야 한다. 이 조건을 만족하는 순서는 reflected code 말고도 많고, 수학적으로는 n차원 hypercube의 꼭짓점을 한 번씩 도는 경로가 모두 gray code다. 각 비트가 바뀌는 횟수를 고르게 맞춘 balanced gray code 같은 변형도 있다. 그러니 원칙적으로는 규칙에 맞게 직접 순서를 정해 써도 된다.
그래도 실무에서는 reflected code를 쓴다. 변환이 XOR만으로 끝나서 counter를 binary로 세고 바꿔 담으면 되고, async FIFO의 full 조건처럼 맨 위 두 비트를 뒤집어 비교하는 방법도 반사 구조에 기대고 있기 때문이다. 순서를 직접 정하면 변환용 table과 full, empty 판정을 따로 만들고 검증해야 한다.
깊이에도 제약이 있다. 한 번 셀 때마다 1인 비트의 개수가 홀수와 짝수를 오가므로, 처음으로 돌아오는 순환 gray code의 길이는 항상 짝수다. Cummings가 23-deep gray code는 만들 수 없다고 쓴 이유다. 짝수이지만 2의 거듭제곱이 아닌 깊이라면 reflected code의 가운데 부분을 쓰는 방법이 있다. 2^n개 중 앞뒤에서 같은 개수를 빼면, 반사 구조 때문에 남은 첫 값과 마지막 값이 맨 위 비트만 달라 순환이 유지된다. 3비트에서 앞의 000과 뒤의 100을 빼면 001, 011, 010, 110, 111, 101의 6개가 되고, 101에서 001로 돌아갈 때도 한 비트만 바뀐다. 다만 binary와의 변환에 offset이 붙고 full, empty 판정도 새로 짜야 한다. NXP(당시 Philips)의 특허처럼 이런 방식을 따로 설계한 사례가 있지만, 대부분은 깊이를 2의 거듭제곱으로 올려 표준 구조를 그대로 쓴다.
CDC는 STA와 RTL simulation으로는 잡히지 않는다
STA는 비동기 clock 사이의 경로를 계산할 기준이 없다. 그래서 두 clock을 비동기 group으로 선언하거나 false path로 빼는데, 그러면 그 경로의 delay가 아무리 길어도 아무도 보지 않는다. 앞에서 본 데이터와 제어 신호의 경주가 여기서 생긴다. AMD의 방법론 문서는 CDC 경로에 set_max_delay -datapath_only로 상한을 걸라고 권한다. 이 옵션은 clock skew와 jitter를 빼고 데이터 경로의 delay만 보며, 값은 보통 보내는 쪽 clock 주기로 잡는다. gray code bus에는 여러 비트가 받는 쪽 같은 edge에 서로 다른 상태로 잡히지 않도록 set_bus_skew를 쓸 수도 있다.
RTL simulation도 CDC 버그를 잘 못 찾는다. simulator에서는 FF가 metastable에 빠지지 않고, synchronizer를 지난 신호는 늘 같은 주기에 도착한다. 실제 칩에서는 한 주기 늦을 수도 있는 신호가 simulation에서는 항상 제때 오니, re-convergence 버그가 simulation을 통과한다. Siemens도 Questa CDC 자료에서 비동기 domain 사이의 전달은 RTL이나 gate-level simulation이 실리콘 동작을 정확히 모델링하지 못한다고 적는다.
그래서 CDC는 전용 툴로 따로 검증한다. Synopsys VC SpyGlass CDC나 Siemens Questa CDC 같은 정적 CDC 툴은 clock 정의를 받아 모든 crossing을 찾고, synchronizer가 빠진 경로, synchronizer 앞의 combinational logic, re-convergence를 구조적으로 보고한다. simulation 쪽에서는 synchronizer 출력을 무작위로 한 주기씩 늦추는 metastability injection을 쓴다. Questa CDC의 CDC-FX가 이런 기능이고, Cummings(2008)도 합성할 때는 보통 2-FF로, simulation에서는 지연을 골라 넣을 수 있는 sync2 model을 소개한다.
정리하면 CDC에서 할 일은 세 가지다. 1비트 신호는 FF에서 바로 나온 값을 2-FF synchronizer로 받고, pulse는 toggle이나 handshake로 level의 변화로 바꿔 넘긴다. 여러 비트는 비트마다 따로 동기화하지 않고, 하나로 합치거나, 데이터를 붙잡아 둔 채 제어 신호만 동기화하거나, 한 번에 한 비트만 바뀌는 gray code pointer를 쓰는 async FIFO로 넘긴다. 그리고 이 구조가 제대로 들어갔는지는 STA와 simulation이 아니라 CDC 전용 검사와 제약으로 확인한다.
참고 자료
- vitamin, open-source RTL simulator (vita)
- Clifford E. Cummings, Clock Domain Crossing (CDC) Design & Verification Techniques Using SystemVerilog (SNUG Boston 2008)
- Clifford E. Cummings, Simulation and Synthesis Techniques for Asynchronous FIFO Design (SNUG San Jose 2002)
- Ran Ginosar, Metastability and Synchronizers: A Tutorial (IEEE Design & Test, 2011)
- Frank Gray, Pulse Code Communication, US Patent 2,632,058 (1953)
- Jens Sparsø, Asynchronous Circuit Design: A Tutorial (DTU)
- AMD, Constraints on Individual CDC Paths (UG1387)
- AMD, ASYNC_REG property (UG912)
- Siemens, Questa Clock-Domain Crossing fact sheet
- Synopsys, VC SpyGlass CDC
- eVision Systems, Tackling CDC re-convergence issues with Aldec ALINT-PRO
- NXP (Philips), Non-power-of-two gray-code counter system, EP1410509A2
- Wikipedia, Gray code