
개발 중인 RTL 시뮬레이터 vitamin이 맞는 답을 내는지 확인하려고, 공개된 서드파티 RTL 여덟 개와 직접 쓴 설계 두 개를 다른 시뮬레이터의 결과와 맞춰 보는 벤치를 만들었다.
현업에서 검증 환경을 만들 때는 꽤 꼼꼼하게 보는 편이지만, 그건 도구를 믿는 사람의 꼼꼼함이었다. 시뮬레이터가 찍은 값은 사실로 놓고 내 설계와 테스트벤치만 의심하면 됐다. 지금은 도구 자체가 개발 중이라 용의자 목록의 세 번째 줄이 지워지지 않는다.
6편에서 도구가 틀릴 때마다 에러를 낸다면 용의자 목록에서 도구를 지울 수 있다고 썼지만, 만들고 있는 도구가 그런지는 무엇으로 알 수 있을까.
게다가 집에는 내 설계가 없다. 개발하는 공간이 현업에 집중하는 공간도 아니고, 내가 쓰던 개발 환경이나 코드도 없다. 그래서 공개된 서드파티 RTL로 시험해 보는 게 맞다고 생각했다. 그것들은 이미 누군가 검증했을 테니까. 내가 쓴 테스트는 내가 의심하는 것만 찾지만, 남이 이미 돌려 본 RTL은 내가 의심하지 않는 것을 찾아 준다. 그래서 여덟 개를 빌려다 놓고 값을 매기기 시작했다.
남의 RTL은 커밋 SHA로만 들고 있다
서드파티 여덟 개는 각각 커밋 SHA로 고정했고 RTL 자체는 재배포하지 않는다. .gitignore가 bench/ 아래를 통째로 막고 테스트벤치, 파일 목록, 실행 스크립트 서른 개 남짓만 도로 열어 주니, 커밋된 건 SHA와 내가 쓴 실행용 파일(하네스)뿐이다. 남의 RTL은 SHA로 다시 받아 올 수 있지만 하네스는 그렇지 않다.
표의 오라클은 vita의 결과를 맞춰 볼 기준 시뮬레이터다.
| # | 이름 | 출처 | 모양 | 라이선스 | 오라클 |
|---|---|---|---|---|---|
| 1 | sha256 | secworks/sha256 | crypto | BSD-2 | iverilog 13.0 (verilator 5.050 일치) |
| 2 | aes | secworks/aes | crypto | BSD-2 | iverilog (verilator 일치) |
| 3 | picorv32 | YosysHQ/picorv32 | cpu | ISC | iverilog만 |
| 4 | darkriscv | darklife/darkriscv | cpu | BSD-3 | iverilog (verilator 일치) |
| 5 | biriscv | ultraembedded/biriscv | cpu | Apache-2.0 | iverilog |
| 6 | serv | olofk/serv | cpu | ISC | iverilog만 |
| 7 | verilog-axi | alexforencich/verilog-axi | fabric | MIT | iverilog |
| 8 | verilog-ethernet | alexforencich/verilog-ethernet | stream | MIT | iverilog (verilator 일치) |
| 9 | keccak | 자체 | crypto | – | iverilog·verilator·Python 참조 셋 일치 |
| 10 | keccak-arr | 자체 | crypto | – | 같음 |
오라클이 먼저 돌지 않은 설계는 받지 않는다
채택 조건은 다섯 개로 못 박았고, 원문은 벤치를 돌리는 러너 코드 안에 있다. 1조는 라이선스다. MIT, BSD, ISC, Apache-2.0만 받고 테스트가 이를 강제한다. 2조는 오라클이 먼저 돈다는 것이다. 오라클이 없으면 아무리 탐나는 설계여도 넣지 않는다. 3조는 출력을 최종 상태만이 아니라 처음부터 끝까지 누적한 해시 한 줄(다이제스트)로 찍는 것이다. 4조는 명시적 $finish와 고정 시드, 워치독을 둬서 매번 같은 결과로 스스로 끝나는 것이다. 5조는 설계를 건드리면 다이제스트가 움직여야 한다는 조건이다.
2조가 순서를 따지는 건 vita를 먼저 돌리면 거절이 나올 때마다 테스트벤치를 깎게 되기 때문이다. 그렇게 깎은 벤치는 잘 통과하지만 아무것도 재지 않는다. 설계를 주워 오는 쪽에 준 지침에도 그대로 적어 두었다. “vita가 거절하거나 틀리는 설계가 네가 가져올 수 있는 가장 값진 결과다. vita가 받아들이게 하려고 RTL을 단순화하거나 재작성하거나 축소하지 마라.”
저장해 둔 다이제스트는 오라클이 낸 답이라서, 다른 시뮬레이터가 하나도 없는 컴퓨터에서도 vita의 결과를 그 값과 비교할 수 있다.
picorv32와 serv에서는 verilator가 오라클이 아니다. 두 설계 모두 레지스터 파일을 초기화하지 않은 채 읽고 그 x를 일부러 쓰는데, verilator는 x 없이 0과 1만 다루는 2-state라 거기서 다른 답을 낸다. 그래서 설계 목록(매니페스트)에 어느 도구의 답을 기준으로 삼는지 행마다 적어 뒀다.
못 들어온 설계도 있다. ibex는 iverilog 13이 struct 타입 localparam에서 구문 에러를 내고, 위치 인자로 바꾸면 내부 어서션에서 abort한다. 오라클이 없으니 2조에 막혀 매니페스트에 들어오지 못했다.
workload           shape   origin    licence      vita      note
sha256             crypto  upstream  BSD-2-Clause runs      the corpus's widest vita margin
picorv32           cpu     upstream  ISC          runs      the reference RISC-V workload; tbd.v accumulates, tb.v does not
serv               cpu     upstream  ISC          runs      bit-serial, ~35 clk/insn — a scheduler-throughput workload.
verilog-axi        fabric  upstream  MIT          split     2x2 crossbar — elaboration- and generate-heavy. ...
keccak-arr         crypto  in-repo   ours         runs      first-party; the corpus worst case, and the only design the arena estimate used

coverage: 10/10 run under vita
  verilog-axi        ruled split: ROADMAP §2-N: t0 continuous-assign event order; iverilog answers two ways to the same question (fires for `a|b`, not for `a&b`)
처음 돌린 여덟 개 중 셋이 같은 이유로 거절됐다
2026년 8월 23일 여덟 개를 처음 돌렸더니 셋이 거절당했다. verilog-ethernet은 문자열 삼항 1 ? “RED” : “BLUE”에서, serv는 문자열 Ident 파라미터에서, verilog-axi는 정수 replication 카운트에서 멈췄다.
서로 상관없는 설계인데 원인은 파라미터 값을 컴파일 때 미리 계산하는 부분(상수 폴딩) 하나였다. 내가 만든 시험 코드로 이미 찾아서 결함 목록에 한 줄 올려 둔 문제였는데, 남의 RTL은 첫 실행에서 그 한 줄을 세 번 밟았다. 최소 재현을 만들어 보니 parameter SI=”RED” 같은 다른 문자열 상수 형태는 이미 정확했고 1 ? “RED” : “BLUE” 하나만 E3009로 거절했다. iverilog와 verilator는 둘 다 RED를 찍는다.
처음에는 부족한 게 3개밖에 안 되나 싶기도 했지만 당연히 그 뒤로 더 나왔다. 문자열 상수를 받도록 고치자, AI에게 일부러 흠을 찾게 한 리뷰에서 꼭 고쳐야 한다고 나온 문제 넷 중 셋이 바로 그 수정에서 생겼다. 문자열과 상관없는 버그도 하나 같이 잡혔다. localparam bit N=8’hFF의 값과 비트 폭이 vita에서는 255와 8, 오라클에서는 1과 1로 나오는 문제였다.
거절 행은 하나씩 닫혀 지금은 10/10, 거절 0이다. 다만 verilog-axi는 지금도 vita와 iverilog의 답이 갈린 채로 남아 있다. 123,166 사이클 중 29 사이클에서 크로스바의 registered valid가 iverilog에서는 x, vita에서는 확정값이다. 사이클 수, 핸드셰이크, 마스터별 데이터 다이제스트는 전부 같다.
여기서는 iverilog 자신이 같은 질문에 두 가지로 답한다. 피연산자도 값도 같은데 a | b를 읽는 always @*는 0 시각에 깨어나고 a & b 쪽은 깨어나지 않는다. 시각 0의 continuous-assign 이벤트 순서 문제다. vita의 답을 기준으로 저장하면 내 답으로 내 답을 검사하는 꼴이 되고, 거절로 두면 영영 실패로 남는다. 그래서 두 다이제스트를 다 저장하고 판정 사유를 적어 두는 세 번째 상태(ruled split)를 만들었다. 둘이 같아지는 날 이 행은 통과로 올라간다.
채점표가 처음엔 좋은 소식을 빨간불로 찍었다
거절도 정상적인 결과로 다루려면 채점표가 필요했다. 행마다 기대값을 돈다, 거절한다, 갈렸다 중 하나로 적어 두고, 실제 실행 결과와 짝지어 등급을 매긴다.
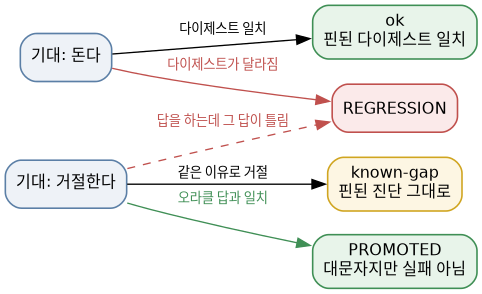
실패로 읽히는 문자열은 REGRESSION, DRIFTED, ORACLE-DRIFT 셋뿐이다. PROMOTED는 막혀 있던 행이 열린 날 눈에 띄라고 대문자로 찍을 뿐 실패가 아니다. 그림의 빨간 점선은 거절하던 설계가 틀린 답을 내기 시작하는 경우로, PROMOTED가 아니라 REGRESSION으로 친다. 6편에서 유일하게 금지한다고 쓴, 거절에서 조용한 오답으로 내려가는 이동이다. 그래서 loud_becoming_silently_wrong_is_a_regression이라는 단위 테스트로 막아 뒀다.
처음에는 종료 코드를 기대값 옆의 자유 필드로 두었는데, 그러다 보니 거절 행이 거절할 때의 종료 코드 1을 들고 있었다. 거절하던 기능이 실제로 구현돼 vita가 0으로 끝나자, 러너는 “was loud, now crashes”라는 문구와 함께 그 행을 실패로 보고했다. 벤치가 기다리던 바로 그 소식을 실패로 찍은 것이다.
해결은 타입으로 했다. 종료 코드를 Expect::Runs { exit } 안으로 넣어 거절 행에는 그 값을 적을 자리가 없게 했다. 이 문제도 AI 리뷰가 꼭 고쳐야 할 문제로 잡아낸 것이고, 내가 찾은 게 아니다.
덧셈기를 망가뜨렸는데 다이제스트가 그대로였다
열 행이 다 돈 뒤 이 벤치가 정말 뭔가를 재고 있는지 따져 봤다. 결정성, 오라클 일치, 사이클 해상도는 통과했고, 설계를 일부러 바꿔 보는 변형 시험 하나만 통과하지 못했다. 시작은 작업 도중 멈춘 AI 리뷰어가 남긴 메모 한 줄이었다. picorv32의 덧셈기를 reg_op1 + reg_op2에서 reg_op1 + 1로 바꿔도 다이제스트 7836648e76208dc9가 바이트 단위로 같았다.
테스트 프로그램이 addi, add, beq뿐이라 계산된 레지스터 값이 버스로 한 번도 나가지 않았고, 다이제스트는 버스만 본다. 40만 사이클 동안 설계 검사라는 이름을 달고 사실은 프로그램 카운터를 추적하고 있었던 것이다.
고치는 건 어렵지 않았다. 프로그램에 sw x5,64(x0) 저장을 넣고 루프 사이에 x1을 이월시키니 새 다이제스트 68d30f61bf9bf1d4가 나왔고 iverilog와 일치했다. 그리고 5조를 새로 만들어 열 행 전부를 다시 확인했다. 이 글을 쓰면서 0.2.0 릴리스 빌드, +N=400000으로 다시 돌려 봤다. 변형은 sed 두 줄로 넣었다가 실험 뒤 되돌렸다.
== 변형 전, tbd.v (누적 다이제스트)
DIGEST=68d30f61bf9bf1d4
== 변형 전, tb.v (최종 상태만 출력하는 원래 테스트벤치)
trap=0 addr=00000014
== 덧셈기를 reg_op1 + 1 로 바꾼 뒤, tbd.v
DIGEST=e952ef19c785efd3
== 같은 변형, tb.v
trap=0 addr=00000014
누적 다이제스트는 움직이니 5조를 통과한다. 그런데 picorv32 프로젝트에 원래 있던 tb.v를 쓰면 덧셈기가 망가진 채로도 똑같은 값을 찍는다. 최종 상태만 보기 때문이다. 3조가 전 구간 누적을 요구하는 이유가 이 네 줄에 있다.
다이제스트가 안 움직였는데 결함은 아니었던 경우
열 행을 다 확인하다가 verilog-ethernet도 다이제스트가 안 움직였다. picorv32와 같은 결함처럼 보였지만 아니었다. 루프백 테스트벤치가 TX와 RX에 같은 lfsr 인스턴스를 쓰고 있어서, CRC 다항식을 바꾸면 TX가 틀린 FCS를 붙이고 RX가 같은 틀린 다항식으로 검증하니 양쪽에서 상쇄됐다. RX 쪽 데이터패스만 건드리자 다이제스트가 바로 움직였다.
그래서 변형은 비대칭이어야 한다는 규칙이 붙었다. 다이제스트를 못 움직인 변형과 잴 수 없는 설계는 겉으로 똑같아 보이는데, 한쪽만 바꾸는 변형이어야 둘을 가를 수 있다.
picorv32 건은 AI 리뷰어가 스스로 낸 결과였다. 리포트는 확인했지만 AI가 분석한 결과만 받은 것이라 심각하게 받아들이지는 않았다. 실패에 대한 부담감도 없었던 것 같은데, 솔직히 이 부분은 나도 잘 모르겠다.
지는 두 행을 표에서 지우지 않았다
정확성 쪽이 정리되고 나서 시간을 쟀다. 릴리스 빌드로 두 도구를 번갈아 돌리고, 첫 라운드는 버리고 세 번 잰 값의 중앙값을 썼다. 비율은 iverilog / vita라서 1보다 크면 vita가 빠르다.
| 워크로드 | vita | iverilog | 비 |
|---|---|---|---|
| sha256 | 1.25 s | 4.06 s | 3.25× |
| verilog-ethernet | 2.24 s | 7.72 s | 3.45× |
| aes | 2.70 s | 6.03 s | 2.23× |
| biriscv | 4.05 s | 9.20 s | 2.27× |
| keccak | 4.24 s | 9.26 s | 2.19× |
| picorv32 | 4.32 s | 7.06 s | 1.64× |
| darkriscv | 6.63 s | 7.10 s | 1.07× |
| serv | 7.42 s | 7.32 s | 0.99× |
| keccak-arr | 13.58 s | 9.14 s | 0.67× |
| verilog-axi | – | – | ruled split, 타이밍 제외 |
시간을 잰 아홉 행의 기하평균은 1.74배, 서드파티 일곱 행으로는 1.93배다.
지는 행은 둘이다. keccak-arr은 서브루틴을 부를 때마다 25원소 배열을 새로 만드는 설계다. serv는 x가 많은 행인데, 열 개 중 컴파일 승인율이 98.6퍼센트로 가장 높으니 컴파일 커버리지 문제는 아니다. 지는 행을 그대로 둔 건 예시가 있어야 다른 사람이 보기 편할 것 같아서다.
첫 측정은 2026년 8월 23일이었고 그때는 서드파티 다섯 행 기하평균 1.61배, 그때 돌던 일곱 행 전체로 1.30배로 더 나빴다. 평균을 끌어내리던 두 행은 내가 쓴 keccak 둘이었다. 자기 벤치를 만들면 유리한 걸 만들게 될 줄 알았는데, 실제로는 벤치에서 가장 어려운 설계를 제 손으로 만들어 놓고 있었다. 이게 다행인 편향인지는 모르겠고, 남의 설계 여덟 개가 옆에 서기 전에는 알 방법도 없었다.
엘라보레이션 비용은 이 벤치로 잴 수 없다
러너는 시간을 재는 실행과 따로 한 번 더 돌려 단계별 시간을 찍는다.
phase split (vita, one probe run each — not the timed rounds)
sha256             elab 0.003s  sim 1.236s  (0% front end)
picorv32           elab 0.021s  sim 4.260s  (0% front end)
열 행이 전부 이렇다. 엘라보레이션 비중이 가장 큰 biriscv가 1퍼센트, 나머지는 0퍼센트다. 그래서 엘라보레이션 비용이 세 배가 돼도 성능 표의 중앙값은 노이즈 아래에서 움직인다. 따로 떼어 재면 biriscv에서 +36퍼센트, 평범한 wire [31:0] 선언 2만 개짜리 모듈에서는 +193퍼센트인데 표에는 안 보인다.
숫자는 찍혀도 자동 검사에 걸 수는 없다. 기준값을 걸려면 선언은 많고 시뮬레이션은 짧은 행이 필요한데 열 개 중에 그런 행이 없다. 3조가 전 구간 누적 다이제스트를 요구하니 채택되는 설계가 자연히 초 단위로 시뮬레이션하고 밀리초 단위로 엘라보레이션하는 쪽으로 쏠린 것이다.
벤치에 없는 모양의 코드도 보지 못한다. stream과 fabric은 각각 한 행뿐이다. 이 열 개에서 1.00배로 측정된 승인 규칙 하나가 mixed-sign 표현식 트리에서는 2~4배짜리였다. 그 모양이 이 설계들의 핫루프에 없었을 뿐이다. 엘라보레이션이 시간 대부분을 차지하는 행도 아직 없다. 그런 행을 넣으려면 저장해 둘 다이제스트와 오라클이 필요한데 지금은 후보가 없다.
레퍼런스가 거의 없는 느낌이었다
모든 것을 의심하며 세운 벤치조차 한 번은 만점을 받은 채 덧셈기가 망가져도 같은 다이제스트를 찍고 있었다.
레퍼런스가 거의 없는 느낌, 만드는 내내 그게 가장 어려웠다.
이전 편은 조용히 틀리지 않기이고, 연재 전체 목차는 1편에 모아 두었다.
코드는 github.com/tjddnr0912/vitamin-rtl-simulator에 있다(MIT / Apache-2.0). 채택 조건과 채점표, 성능 표는 저장소 docs/study/03-workload-corpus.md에, 이를 구현한 코드는 crates/corpus-runner에 있다. 실행 출력은 모두 0.2.0 릴리스 빌드에서 직접 돌린 것이다.
개발 중인 개인 프로젝트의 기록이고 상용 검증 도구를 대체하지 않는다. 본문의 구현 범위는 집필 시점(2026-09-13, 0.2.0, 테스트 7,203 green) 기준이라 이후 바뀐다. 이 프로젝트는 AI와 협업해 개발하고 있다.